
Noema Lab / 教程
AI音乐入门指南 零基础完成第一首歌曲候选
不用懂乐理和乐器,按定目标、写提示词、排段落标签、生成与试听五步走,完成你的第一首 AI 音乐。
本页目录
零基础使用 AI 创作音乐不需要学过乐理或会弹奏乐器,可以尝试做出第一首歌曲或纯音乐候选,实际耗时取决于排队、生成与试听过程。这份 AI音乐入门指南把整个创作过程拆成五个可执行的步骤,先想清楚要表达的情绪与曲风,再用结构化的英文提示词描述声音方向,接着在歌词里加入方括号结构标签提示段落起伏,最后通过多版试听、参数微调和后期裁剪选出可用版本。当前文本生成音乐模型会把文字当作概率性的风格方向,无法保证精确照谱演奏指定拍速或特定秒点,因此更稳妥的做法是先产出多组候选,再由创作者试听筛选并完成收口。
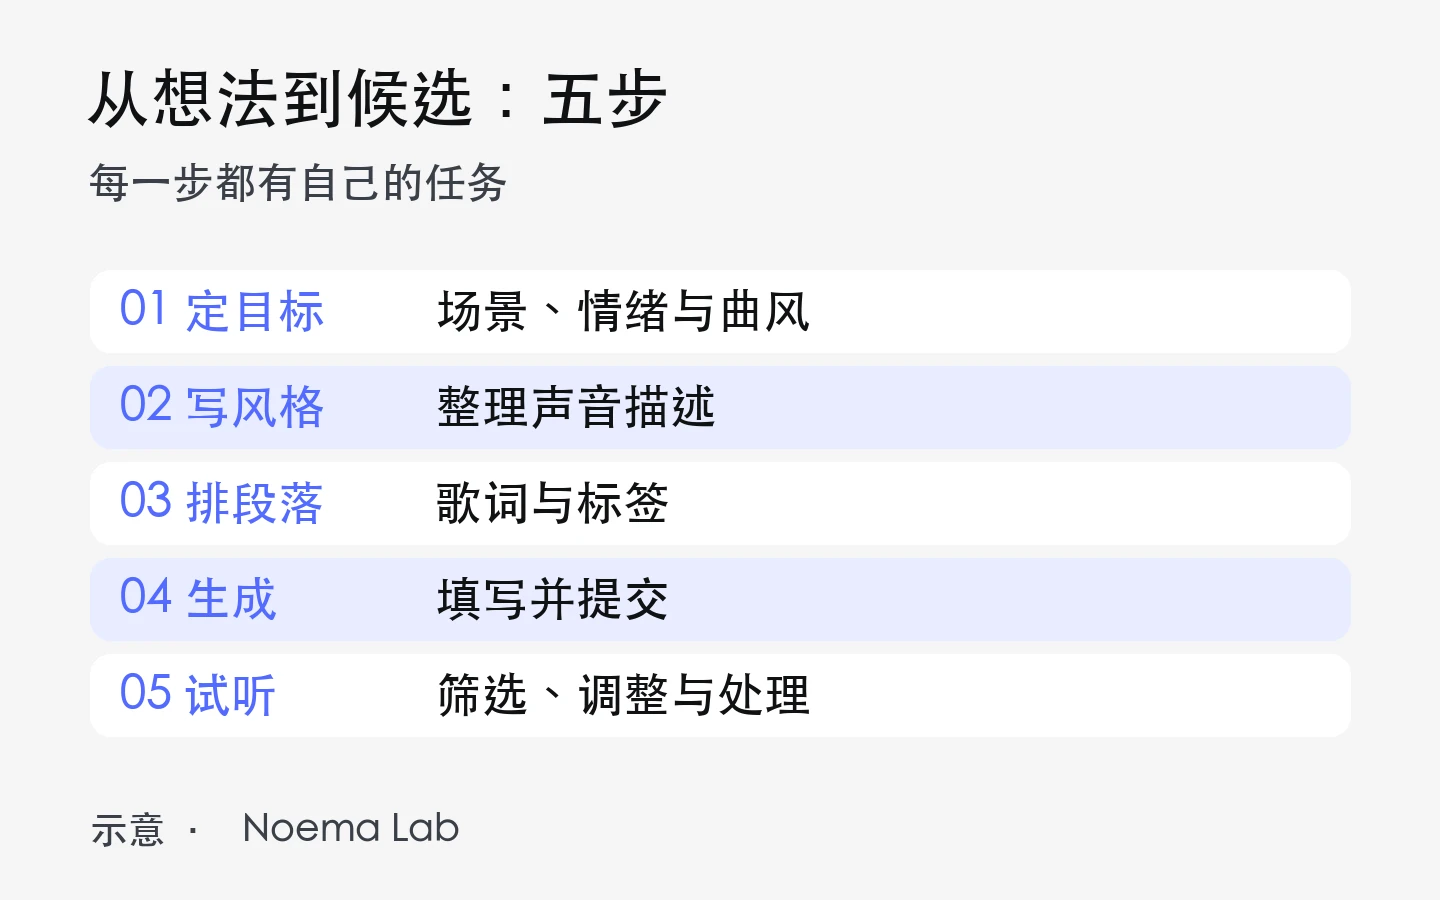
很多人第一次打开音乐生成页面时,习惯在输入框里只写一句”帮我写一首好听的歌”或者”伤感一点的流行歌”。这样写信息太少,模型往往给出一首从头平铺到尾、听不出记忆点的音频。想要稳定得到结构清楚的作品,关键在于动手前把”歌词内容”和”声音风格”拆开准备。下面按从零到一的实际操作顺序,把每一步怎么想、怎么填、怎么改讲透。
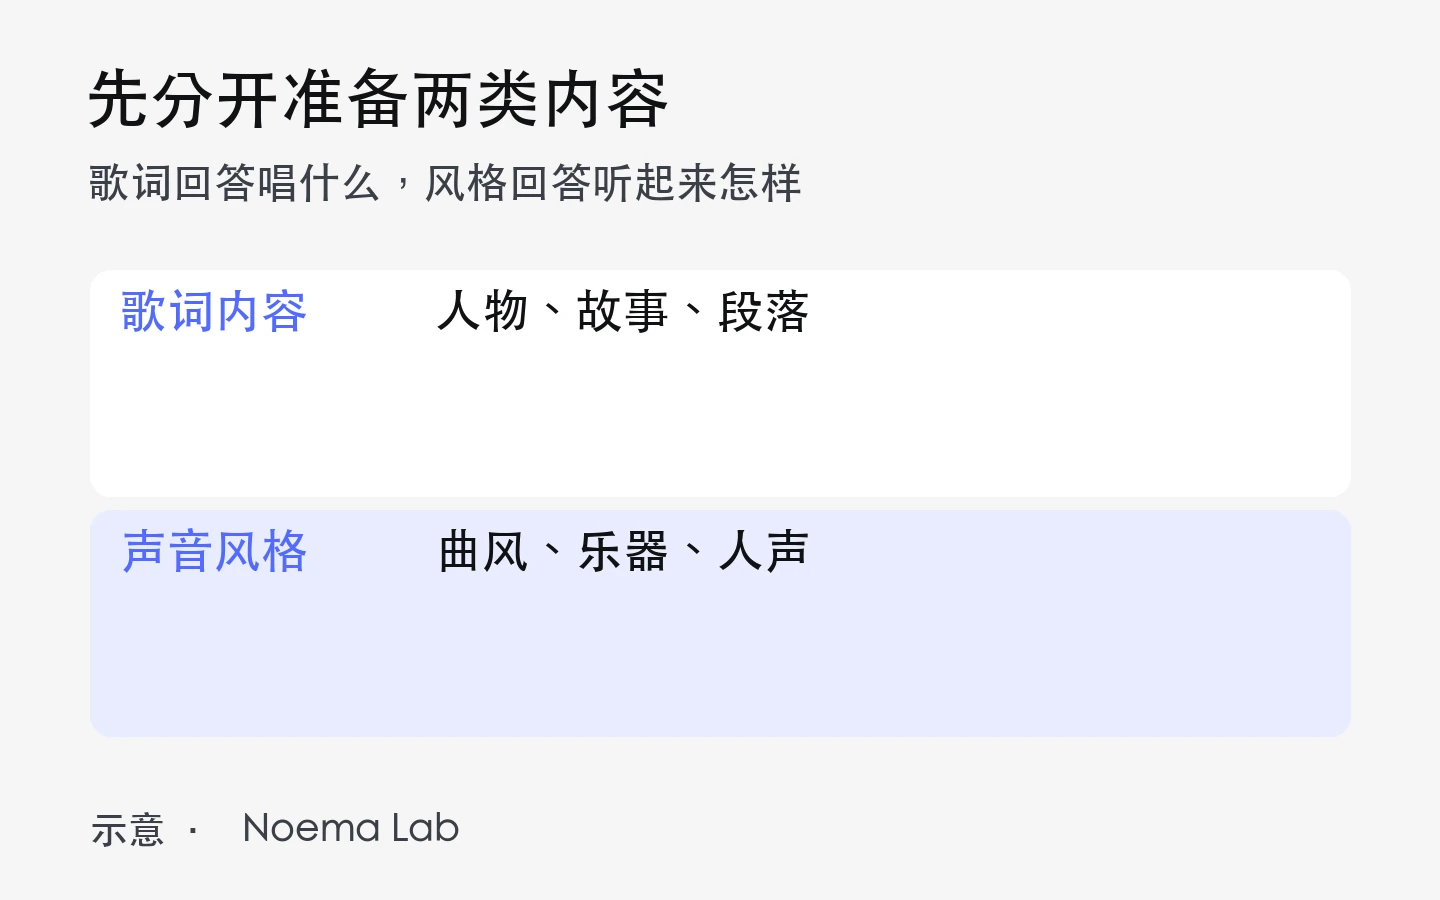
第一步 动手前先确定创作目标与音乐风格
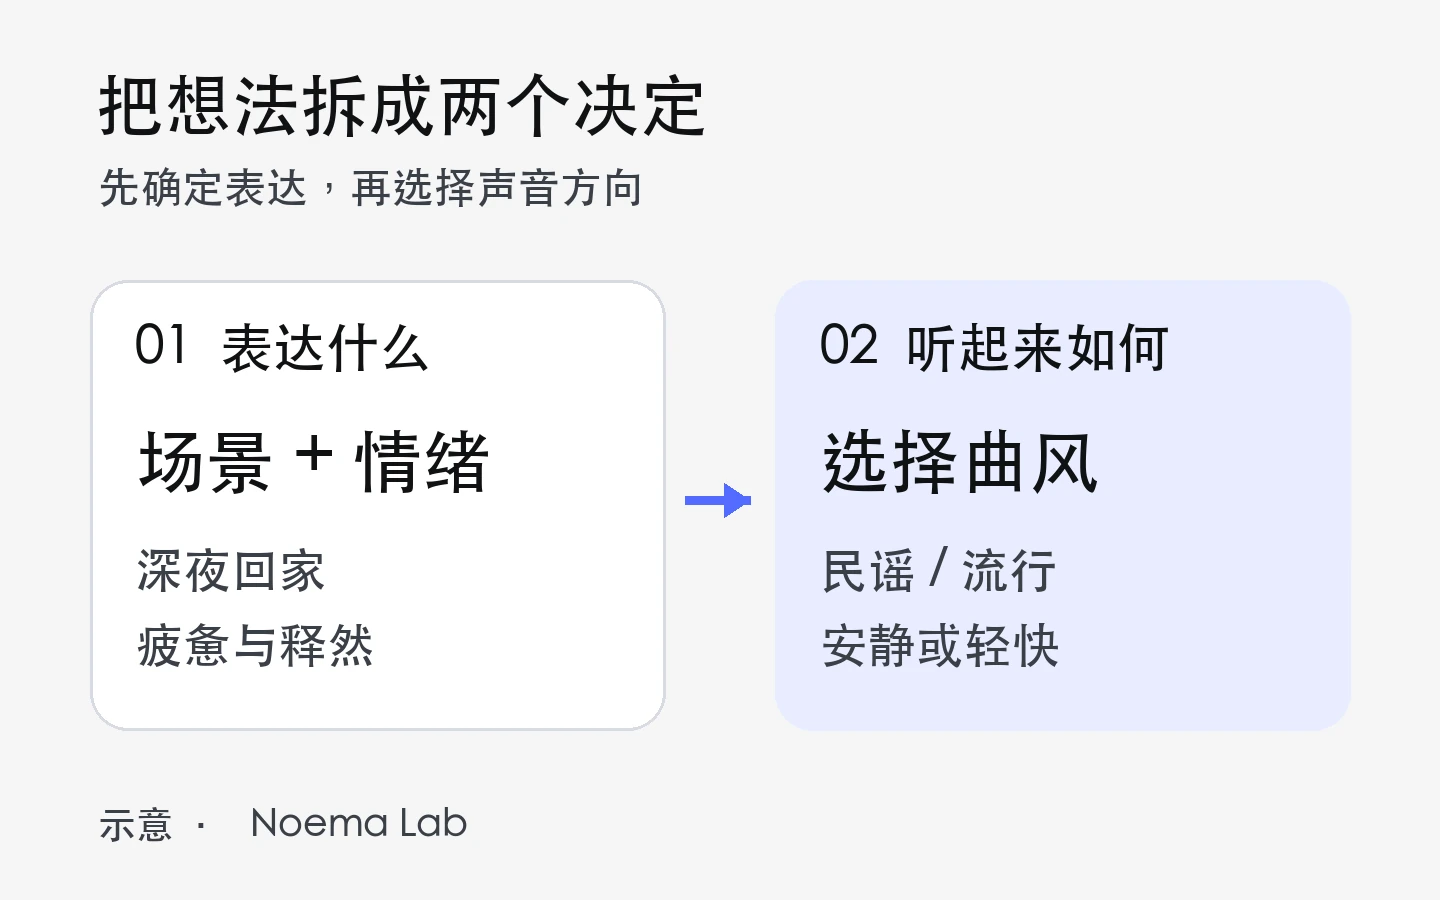
打开生成工具之前,先花两分钟把脑海里模糊的念头变成两个具体决定,也就是这首歌要讲什么情绪,以及它听起来属于哪种音乐类型。如果这一步没想清楚,后面无论怎么改提示词,听起来都会像在碰运气。
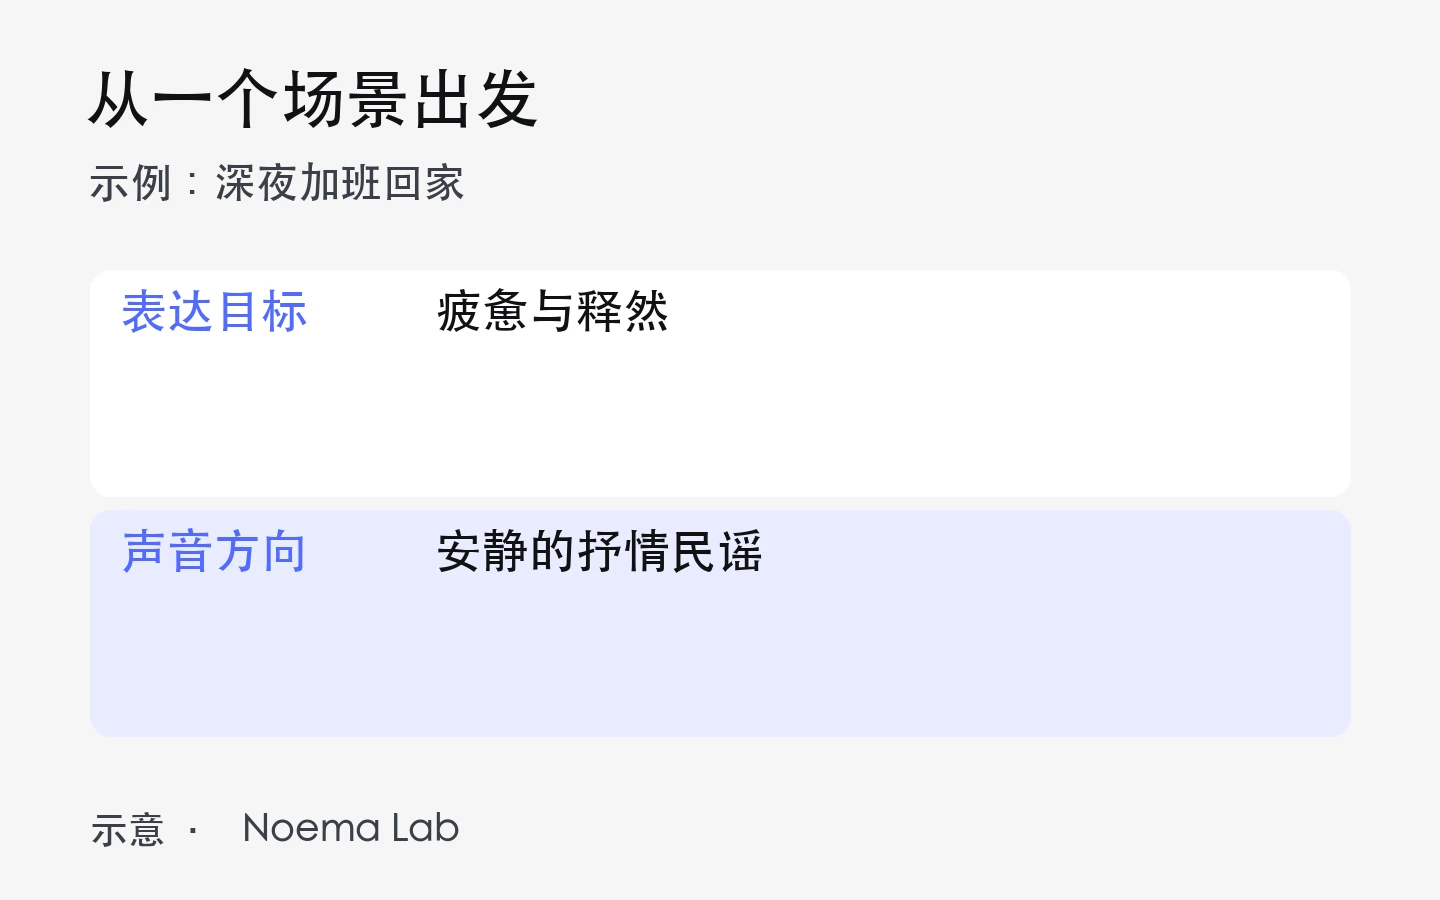
先定表达目标,再选听觉外壳。表达目标不需要写成一篇长散文,用一句话说清场景和情绪就够了,比如”深夜加班回家的疲惫与释然”或者”周末自驾去海边的轻快心情”。有了画面之后,再挑一个贴近这种情绪的音乐流派。常见的新手友好流派包括流行、民谣、摇滚、电子舞曲、国风和爵士。情绪偏安静叙事时,民谣和抒情流行更容易让听众听清歌词;想要画面推进感或运动氛围时,流行摇滚和电子舞曲的鼓点更容易撑起节奏。
在这一步还要顺手决定一个关键开关,到底要不要人声演唱。如果是做有故事的完整歌曲、短视频主题曲或个人心情记录,选择带人声的歌曲模式;如果是做播客垫乐、读书视频背景音或画面旁白配乐,直接选纯音乐模式会省去很多后期麻烦,因为没有人声和旁白抢频段。如果你对不同场景该配什么风格还拿不准,可以先参考 音乐风格挑选怎么做,从用途简报到两组候选试听 里给出的场景对应思路。
第二步 掌握音乐提示词的核心公式
AI 生成音乐的听感上限,很大程度取决于你在风格描述框里写了什么。根据 Meta AI 关于可控音乐生成的研究论文(arXiv:2306.05284),该研究展示了用文字描述或旋律特征作为条件生成音乐的方法;它不能证明所有模型都会随描述变长而更稳定。对新手来说,记住一条包含五个维度的提示词公式就足够应付绝大多数场景。
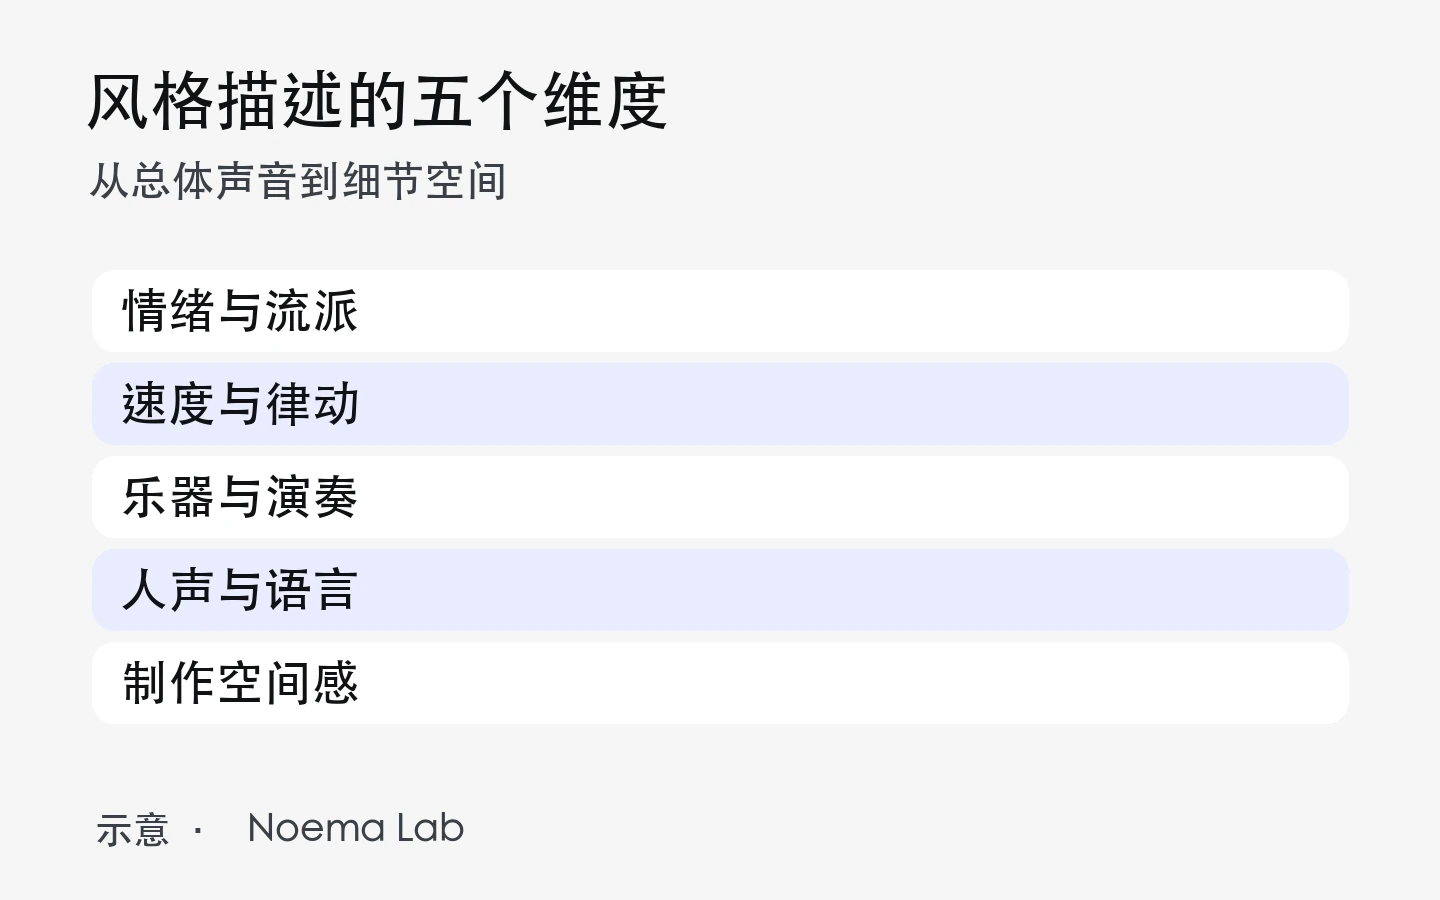
这条公式可以按顺序记成”情绪与流派 + 速度感知 + 乐器与演奏方式 + 人声质感与语言 + 制作空间感”。下文用英文短语展示常见音乐术语的写法,也可以使用清楚的中文描述;不同模型的语言响应需要通过实际试听比较。下面拆开说明每个部分怎么挑词。
情绪与流派放在最前面,方便自己优先核对核心方向;这不代表所有模型都会给靠前的词汇更高权重。你可以用 melancholic(忧郁的)、uplifting(振奋的)、intimate(私密的)、energetic(充满活力的)或 dreamy(梦幻的)来定情绪基调。流派尽量写到细分类型,比如 Acoustic Folk(木吉他民谣)、Mandopop Ballad(华语抒情流行)、Synthwave(合成器浪潮)或 Lo-fi Hip Hop,这比单独写一个 Pop 或 Rock 更有辨识度。如果你还不习惯用英语乐理词汇描述听感,也可以先读一遍 不会乐理,怎样开始用 AI 做音乐?,先用快慢、疏密、明暗和空间感建立自己的判断词库。
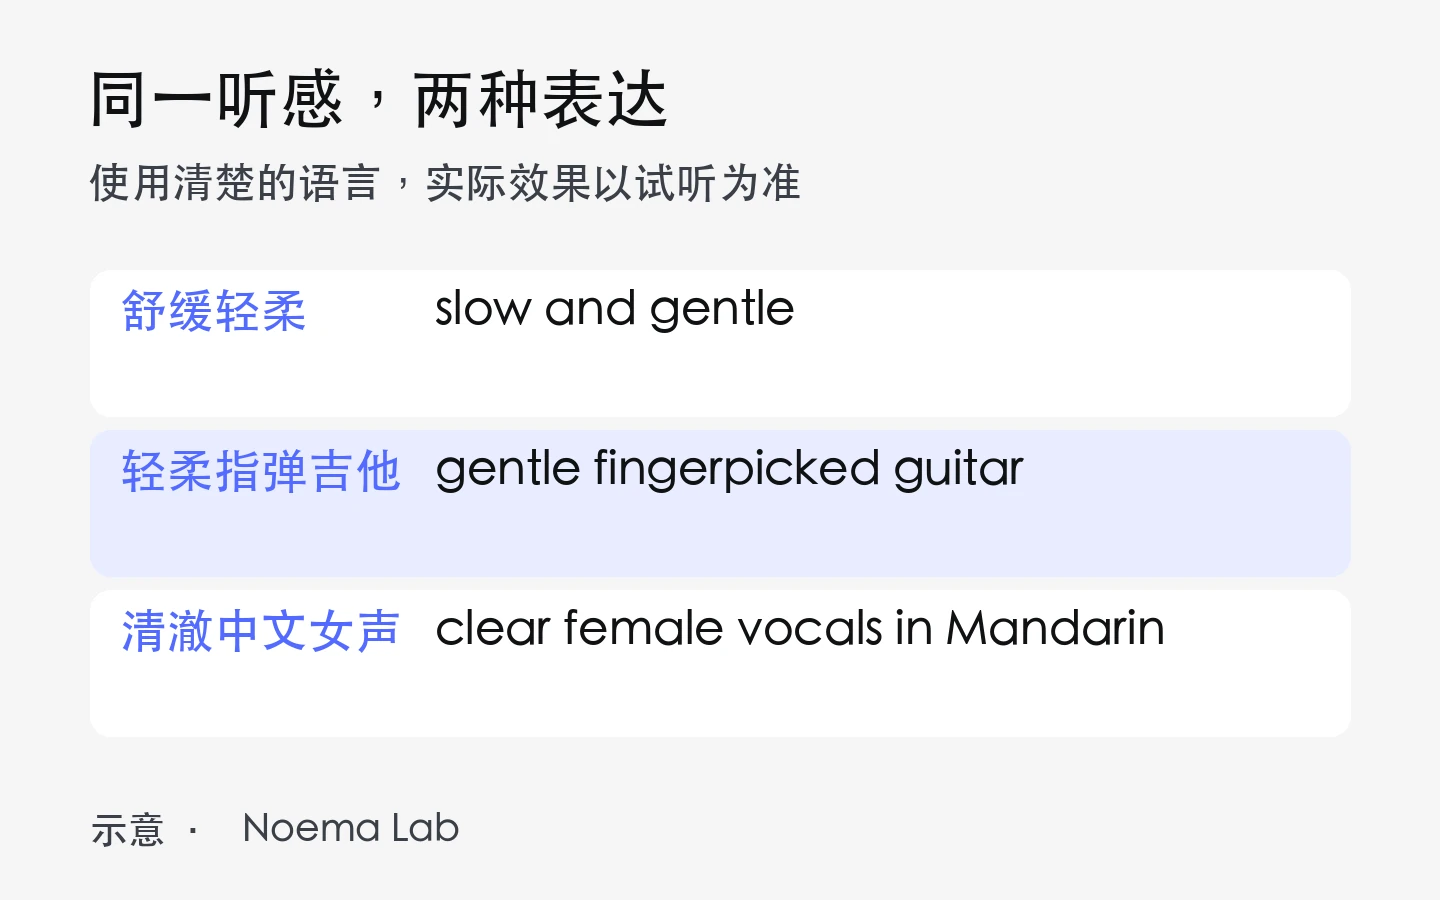
速度与律动用相对感知词配合大致范围来表达。比如用 slow, gentle groove 描述舒缓抒情的歌,用 mid-tempo, steady beat 描述日常叙事感,用 upbeat, driving rhythm 描述轻快奔跑感。即便你在风格句里写上大致的拍速参考作为偏好,也要知道模型不会像节拍器那样严格锁死每一拍的毫秒间隔,它只是朝那个快慢区间靠拢。
乐器配置不要只丢几个名词上去,最好顺带写出它的演奏动作或音色质感。比如写 gentle fingerpicked acoustic guitar(轻柔指弹木吉他)或 warm felt piano playing soft arpeggios(温暖毛毡钢琴弹奏柔和琶音),模型就能区分这是安静铺底还是激烈扫弦。如果是纯音乐模式,记得在人声位置明确写出 no vocals, instrumental only,避免模型习惯性哼出人声。
人声描述要写清性别、音色质感和演唱语言。常见且好用的组合有 clear female vocals in Mandarin(清澈女声中文演唱)、warm husky male vocals(温暖沙哑男声)或 breathy intimate vocals(贴耳气声唱腔)。制作空间感放在最后收尾,用来定整首歌的混音氛围,比如 clean modern mix with subtle reverb(干净现代混音带轻微混响)或 warm analog lo-fi texture(温暖模拟复古质感)。
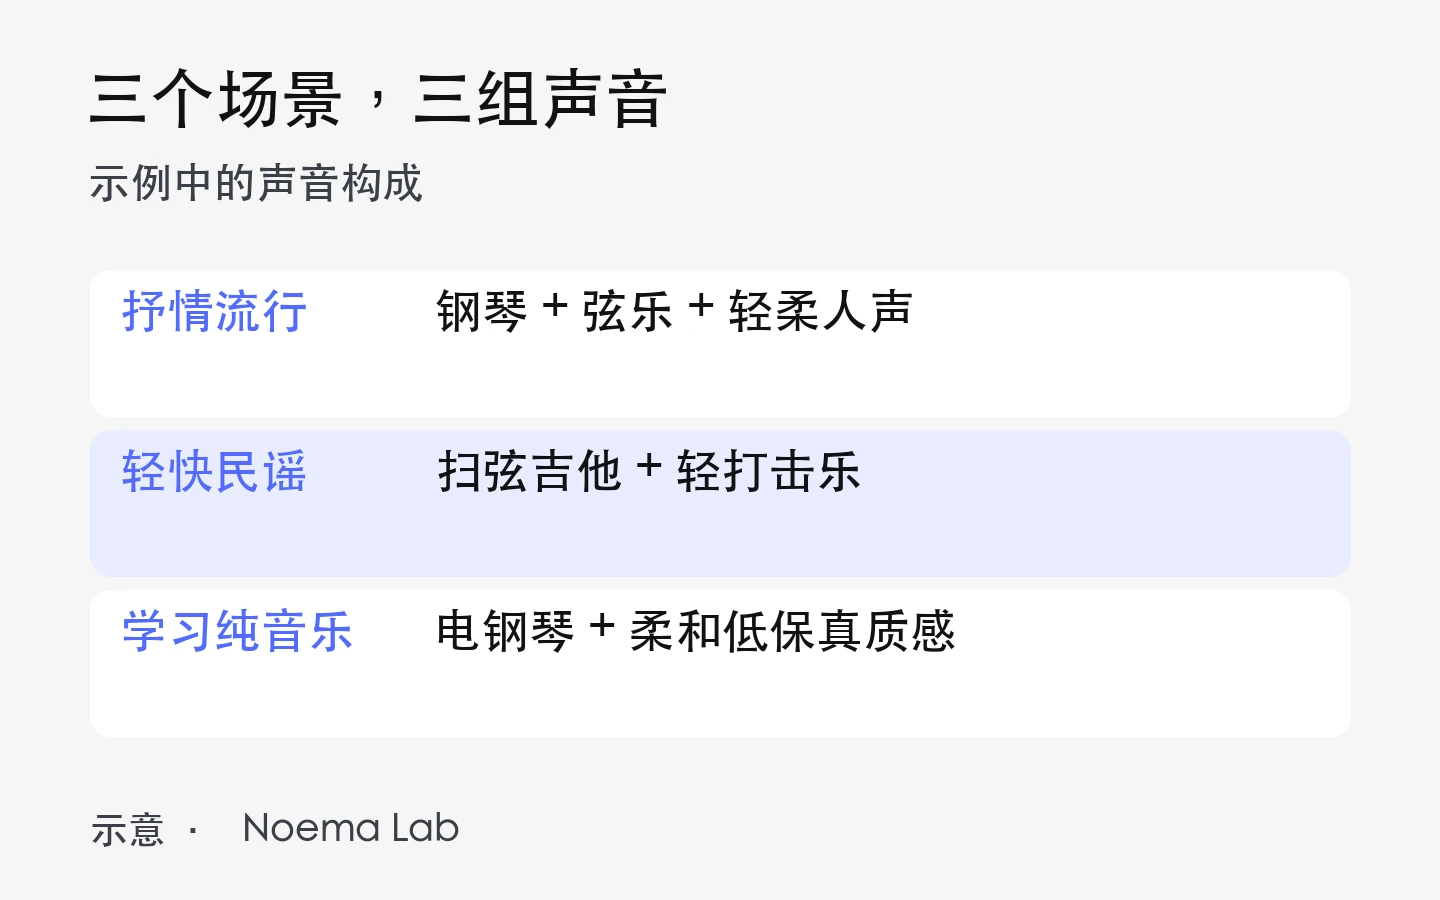
为了让你直观看到写法差异,下面对照三种新手最常尝试的曲风,列出容易踩坑的词堆砌写法和改写后的有效写法。
华语抒情流行
- 新手容易踩坑的写法:伤感,流行,钢琴,弦乐,女声,好听
- 改写后的结构化英文描述:Sentimental Mandopop ballad with a melancholic mood, slow gentle tempo, soft acoustic piano arpeggios and warm sustained strings, breathy female vocals in Mandarin, intimate mix with subtle reverb
- 改写后更清楚的内容:去掉空泛评价词,补齐了华语抒情细分流派、钢琴演奏动作、女声气声质感和混响空间
轻快民谣出行
- 新手容易踩坑的写法:民谣,吉他,开心,节奏快
- 改写后的结构化英文描述:Uplifting indie folk with a bright warm mood, upbeat steady rhythm, crisp strummed acoustic guitar and light percussion, clear male vocals, natural dry acoustic production
- 改写后更清楚的内容:把模糊的”开心”转成明确的独立民谣语境,说明吉他扫弦方式和自然干声质感
夜间学习纯音乐
- 新手容易踩坑的写法:纯音乐,学习,安静,钢琴,电子
- 改写后的结构化英文描述:Calm lo-fi chillhop instrumental with a relaxed dreamy mood, slow laid-back groove, warm electric piano chords and soft vinyl texture, no vocals, wide atmospheric mix
- 改写后更清楚的内容:明确写出无人声指令,用低保真电钢琴和黑胶质感代替抽象的”安静”
第三步 用方括号结构标签提示歌曲段落
写好风格描述框之后,下一步是处理歌词框。很多新手直接把一整段散文或几句押韵的诗粘进歌词框,生成的歌曲往往会一口气唱完,或者把最想突出的那句话唱得平平淡淡。要让 AI 唱出主歌铺垫、副歌爆发的起伏感,可以在歌词框里加入方括号包裹的英文结构标签作为提示;是否响应取决于所选模型,标签不是段落执行保证。
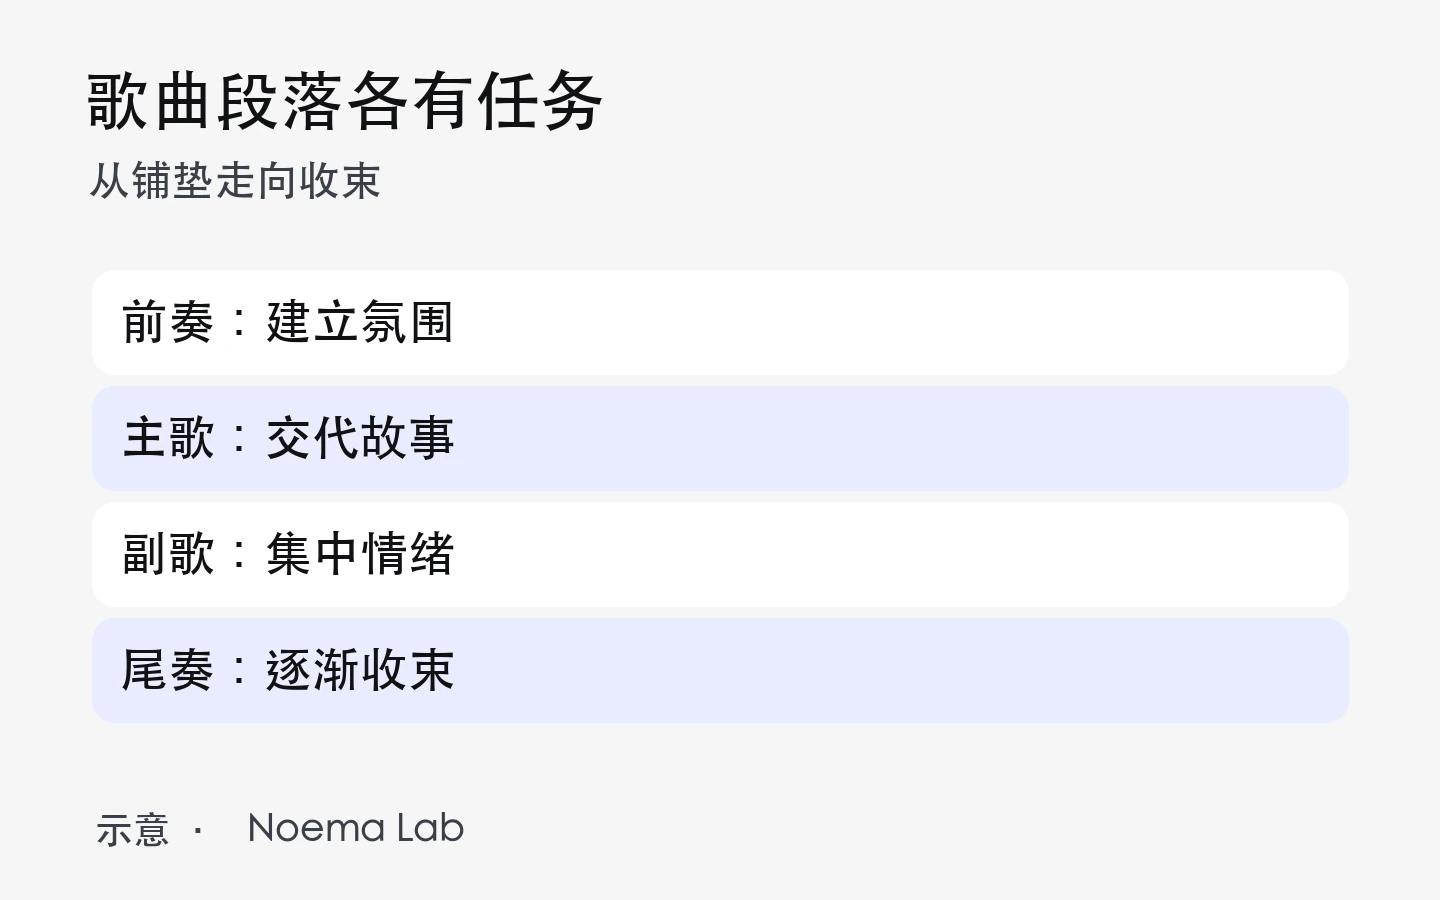
根据 歌曲结构百科(Wikipedia Song structure) 对现代流行音乐曲式的梳理,流行歌曲可包含前奏、主歌、预副歌、副歌、桥段和尾奏,具体组合并不固定,每个段落承担不同的叙事与情绪任务。前奏用来建立听觉氛围;主歌负责交代时间、地点和具体故事细节,编曲和旋律通常相对克制;预副歌负责把情绪往上推一把;副歌是全曲情绪最高、歌词最集中也最容易记住的部分;桥段常出现在歌曲后半段,通过换一种旋律走向或视角带来新鲜感;尾奏则让乐器慢慢收束结束。
在 AI 音乐工具的歌词框里,你不需要写复杂乐理指令,只要把下面这些标准英文标签单独占一行,放在对应段落的歌词上方就行。如果还想提醒模型这一段的唱法或配器变化,可以在标签下方或同一组里用英文圆括号做简短补充,但部分模型可能忽略这些文字或将其唱出,需试听确认。
[Intro]
(Soft acoustic guitar fingerpicking, warm ambient pad)

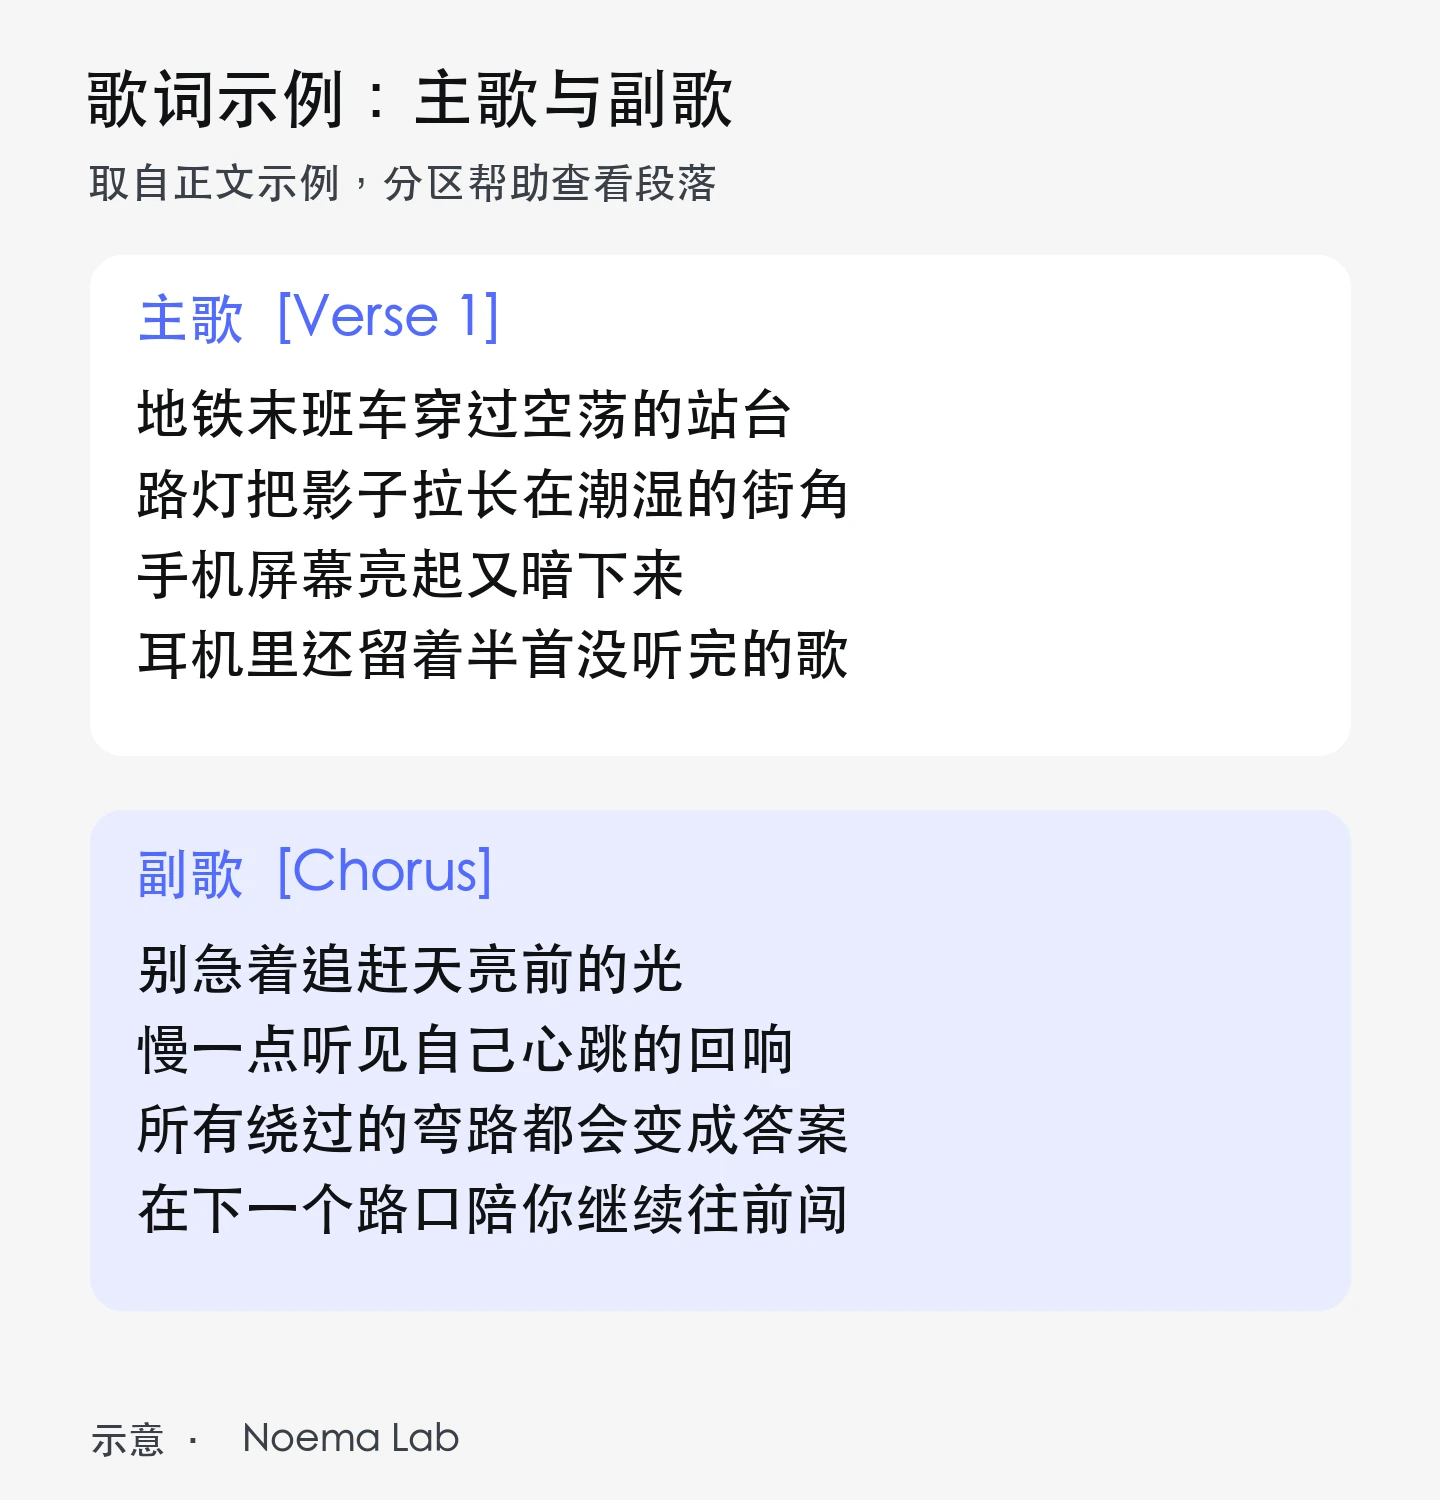
[Verse 1]
(Gentle intimate vocals, sparse arrangement)
地铁末班车穿过空荡的站台
路灯把影子拉长在潮湿的街角
手机屏幕亮起又暗下来
耳机里还留着半首没听完的歌

[Pre-Chorus]
(Light percussion enters, building energy)
风吹过衣领带来一点凉意
回头看这一年走过的距离

[Chorus]
(Full arrangement, soaring emotional vocals)
别急着追赶天亮前的光
慢一点听见自己心跳的回响
所有绕过的弯路都会变成答案
在下一个路口陪你继续往前闯

[Verse 2]
(Steady rhythm, warm bass enters)
桌角的咖啡已经凉透了半杯
未完的草稿纸折起放在包里
明天早上推开门还是晴天
把昨晚的犹豫留在昨夜的雨里

[Chorus]
(Full arrangement, layered harmonies)
别急着追赶天亮前的光
慢一点听见自己心跳的回响
所有绕过的弯路都会变成答案
在下一个路口陪你继续往前闯

[Bridge]
(Stripped back piano and vocals, reflective mood)
就算偶尔也会怀疑方向
至少这一刻还在认真歌唱

[Chorus]
(Powerful final chorus, full band)
别急着追赶天亮前的光
慢一点听见自己心跳的回响
所有绕过的弯路都会变成答案
在下一个路口陪你继续往前闯

[Outro]
(Acoustic guitar fades out gently)
[End]
如果你想做一首 60 秒左右的短视频配乐或片段歌曲,不需要塞进这么多段落,保留 [Intro]、[Verse 1]、[Chorus]、[Outro] 和 [End] 就足够了。段落标签越精简清晰,模型越不容易唱串行。对于中文歌词来说,副歌和主歌的押韵是否顺口会直接影响模型演唱时的自然度,写词阶段如果觉得句子拗口,可以先参考 歌词生成器怎么用,主题、曲风情绪与结构化押韵修改指南 把韵脚理顺。
如果是做纯音乐,也要准备声音方向。切到支持的纯音乐模式后,不需要输入任何演唱文字,但可以在心里按照起承转合把期望的能量变化写进风格描述里,例如开头柔和铺垫、中段鼓点进入、后段逐渐收尾,作为相对能量方向供模型参考,生成后仍需试听确认。
第四步 在 Noema Lab 中完成一次完整创作
了解原理后,直接按顺序跑通一遍完整流程是最快掌握手感的方法。你可以从 Noema Lab(aimusic-tools.com) 进入工作台,把原本分散在不同网页的写词、改提示词、生成歌曲和后期裁剪连成一条线。下面按新手最顺手的操作路径走一遍。
首先打开一键写词或灵感发掘整理你的原始想法。如果你手里只有一句”想写一首送给毕业季朋友的轻快民谣”,可以在一键写词里输入主题,先拿到歌词与风格提示词初稿,再检查段落标签与文字是否符合自己的需要。拿到的歌词读一遍,把不符合自己经历的词句改掉,顺便检查每句字数不要相差太离谱。
接着如果你是自己手写的提示词,或者想看看哪几个英文描述词不够准确,可以进入提示词优化或提示词打分。在提示词打分里粘贴你的风格描述和歌词,检查流派、情绪、乐器、人声和制作质感有没有漏项;如果觉得风格句不够丰满,可以用提示词优化把自然语言拆成结构化的属性,微调强弱之后再合并成一段完整英文描述。
准备好歌词和风格描述后,进入音乐生成页面。在界面上依次核对这几项实际控件,先选定你要使用的生成模型,再根据作品需要及当前模型支持情况选择人声性别,或者切换为纯音乐模式;接着把带方括号标签的歌词粘贴进歌词框,把英文风格描述粘贴进风格描述框,并填写一个歌曲标题。如果当前所选模型开放了高级选项,可以按实际显示的选项调整;风格权重、创意偏离度、排除项或单次生成歌曲数并非每个模型都提供。新手第一轮建议保持默认权重,有多首选项时可生成两首候选;只返回一首时,也可以试听后再决定是否另做一版,避免刚上手就把创意偏离度拉得太高导致曲风跑偏。
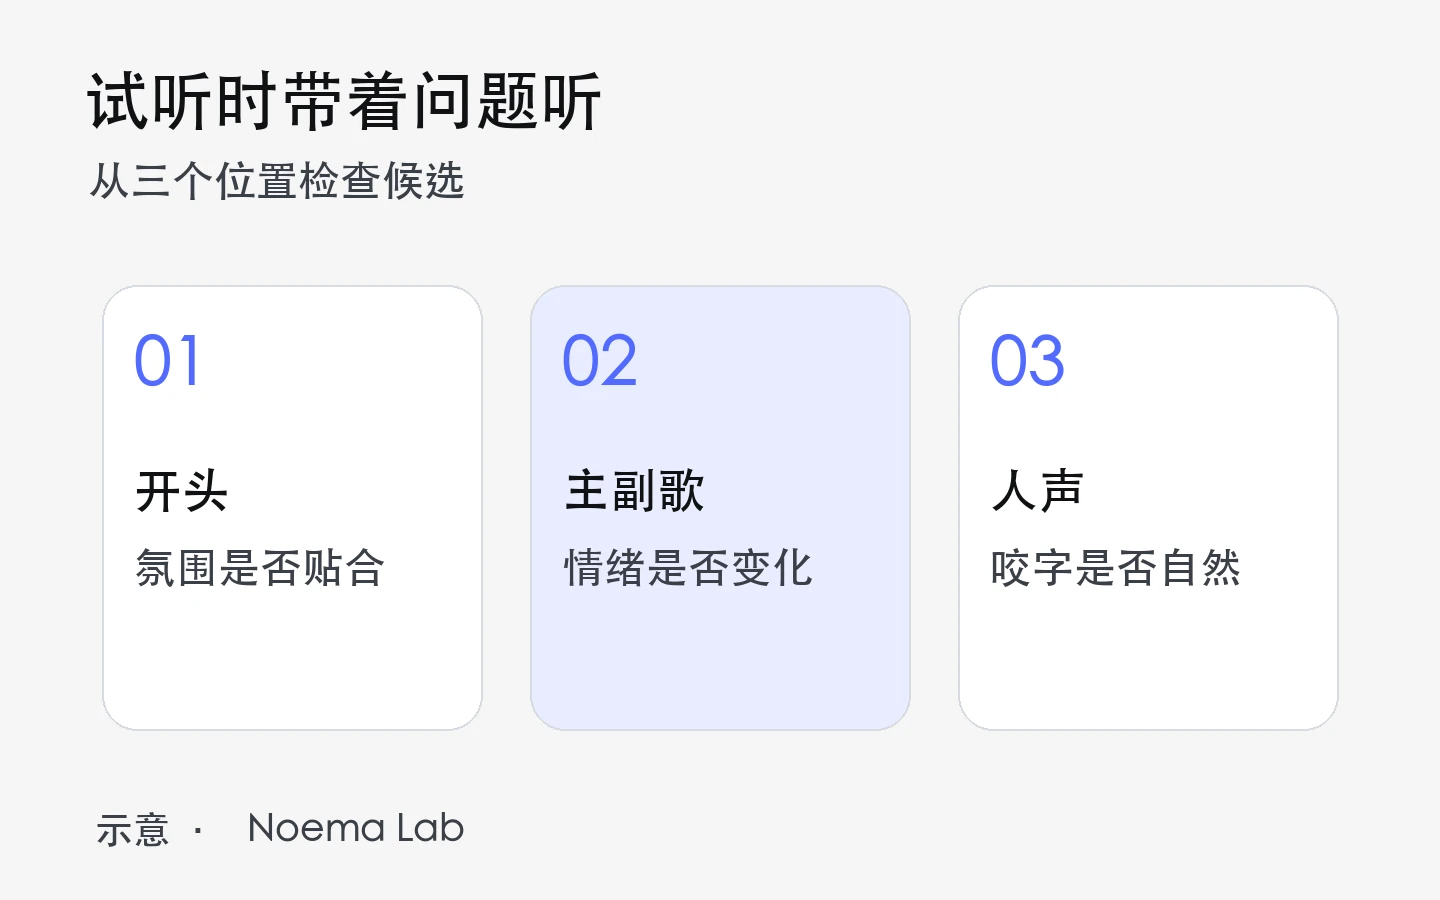
任务完成后,先别急着下载,把已有候选从头听到尾。重点听三个地方,开头前十秒的乐器氛围对不对、主歌进副歌时情绪有没有抬起来、中文咬字有没有明显生硬的地方。挑出整体旋律和人声最顺耳的那一版,准备进入下一步微调或后期。如果你想了解站内更多模块之间怎么配合,可以查看 AI音乐工具箱怎么选与怎么用 从灵感写词到分轨包装的全流程指南。
第五步 试听不满意怎么排查与微调
AI 音乐生成带有一定随机性,第一轮出歌很少一次就完美。关键在于听出问题出在哪里,再对症下药,而不是盲目把同一组提示词连点十次。下面整理了新手试听后最常遇到的四种不满意情况和对应的调整动作。
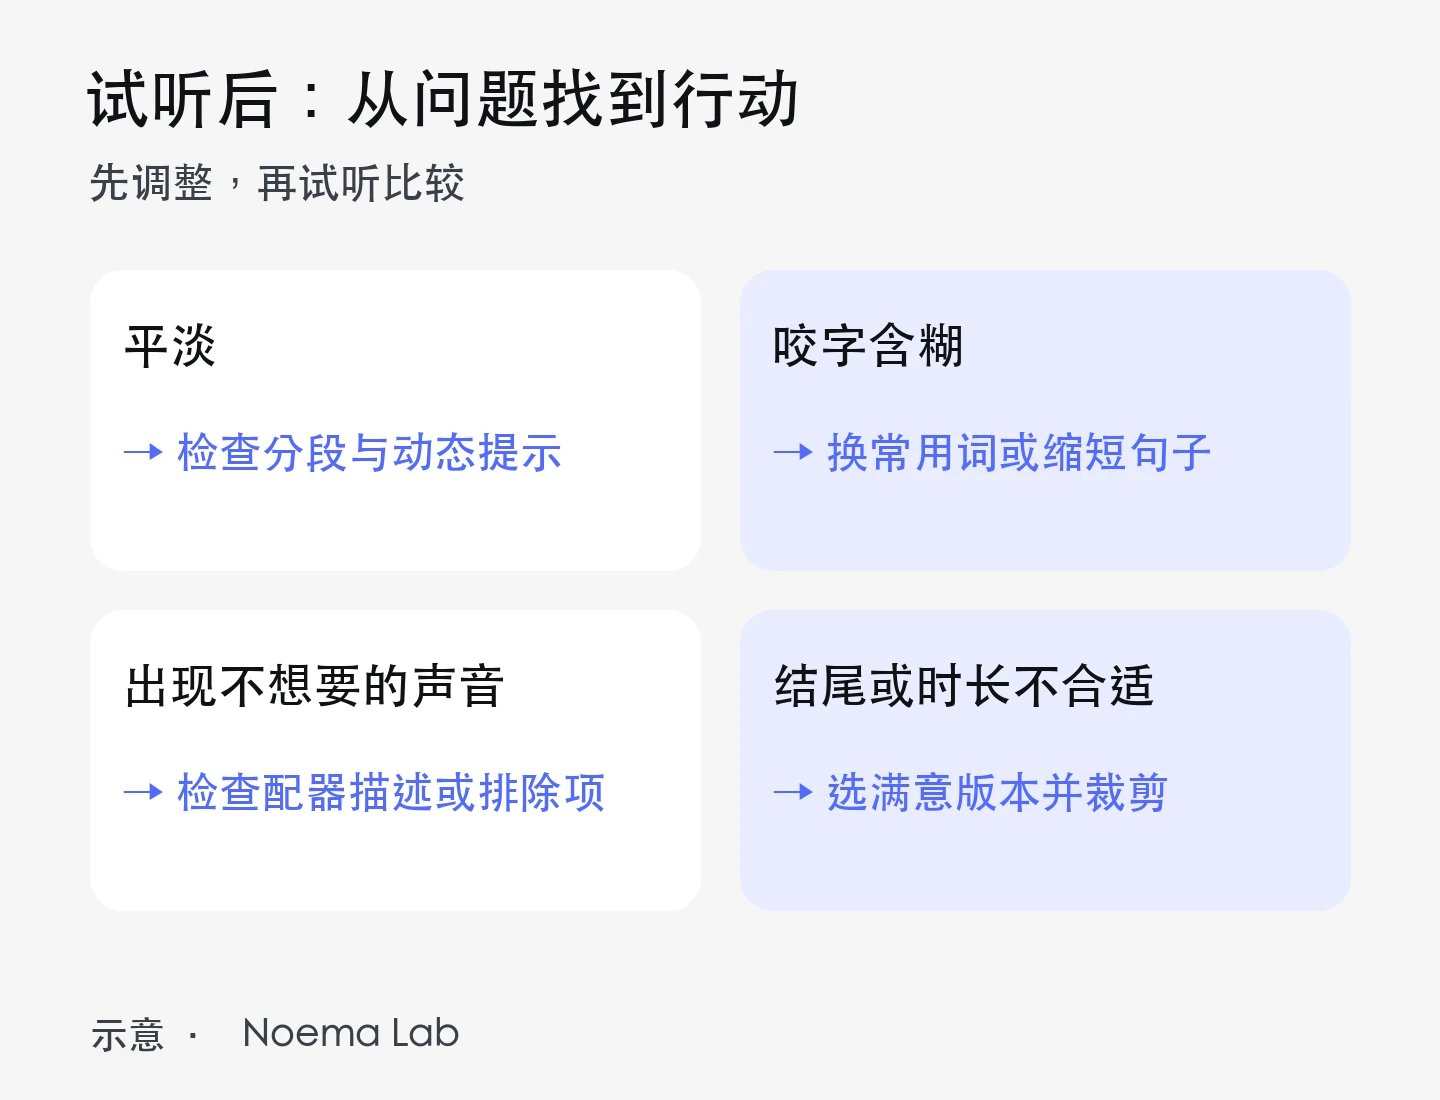
整首歌平淡没有高潮
- 常见原因判断:可能缺少段落对比,也可能是这一轮候选未响应描述
- 第一步调整动作:检查
[Pre-Chorus]和[Chorus]是否单独成段,并在风格描述里补充动态变化方向 - 进阶补救思路:若模型提供风格权重,可小幅调整后试听比较,不保证特定起伏
某几个中文字唱得含糊或吞音
- 常见原因判断:连续生僻字、多音字或单句字数突然过长
- 第一步调整动作:把含糊的那个字换成同义且开口音更响亮的常用字,保持上下句节奏长度一致
- 进阶补救思路:使用易唱优化功能辅助排查拗口字词后再重新生成
曲风里混进了不想要的乐器或电音感
- 常见原因判断:风格描述太宽泛,生成结果没有完全符合声音方向
- 第一步调整动作:若当前模型提供高级选项的排除项,可写明不想要的元素,比如 heavy distortion 或 electronic drums
- 进阶补救思路:把风格描述里的乐器演奏方式写得更具体,压缩模型自由脑补空间
歌曲结尾太突兀或时长超出视频需要
- 常见原因判断:模型自行判断在某个节点收尾,或者前奏拖得太长
- 第一步调整动作:不要反复靠重写提示词逼模型卡死秒数,直接下载最稳的一版候选
- 进阶补救思路:进入音频裁剪切掉多余前奏或尾音,需要渐弱时,另用支持淡出的音频编辑软件处理
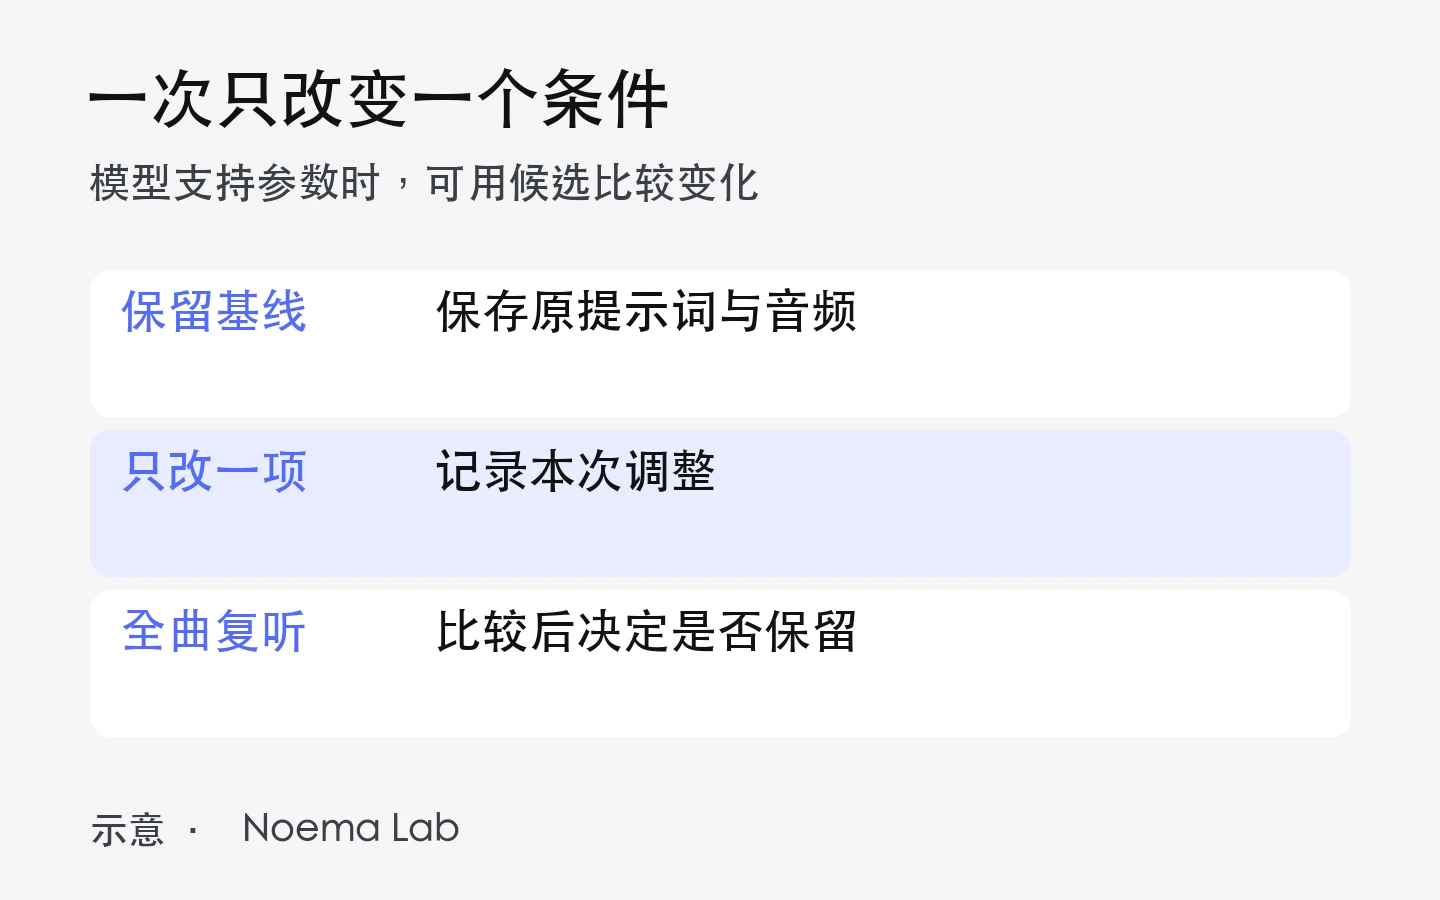
在调节高级参数时,记住两个实用原则。若当前模型提供这些参数,想尝试更贴近风格描述的候选,可小幅提高风格权重,同时把创意偏离度保持在偏低或中等位置;参数并不保证模型严格执行描述;相反,如果你觉得连续两版旋律都太套路、想听听更意想不到的编曲走向,再适度提高创意偏离度,看看模型能不能撞出新的旋律线。
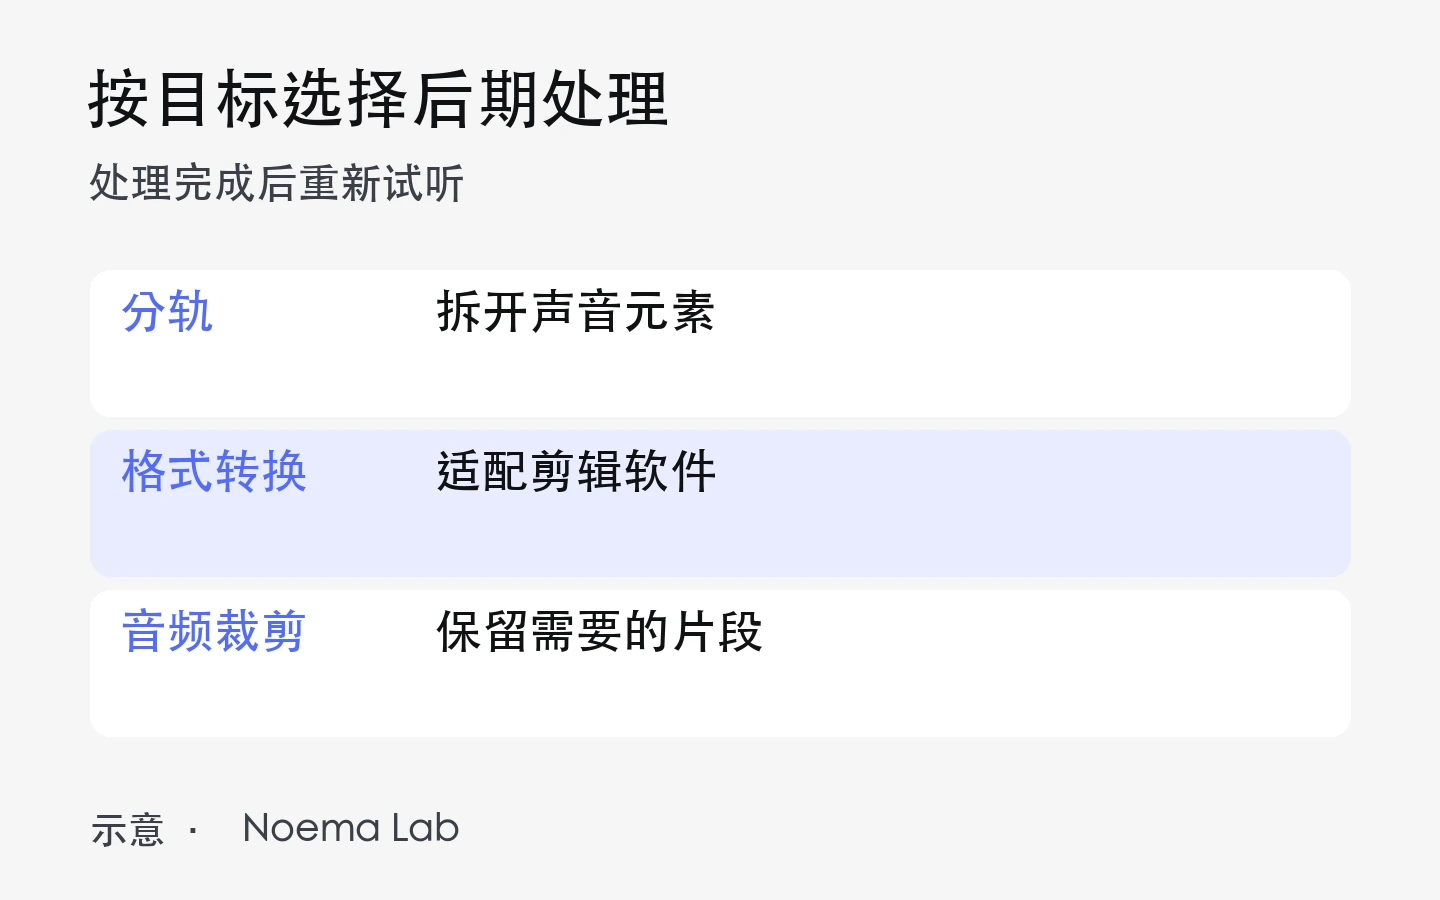
如果某一版生成的旋律很抓耳,你想把伴奏单独抽出来当视频背景音乐,或者换个格式方便导入剪辑软件,可以使用工作台里的分轨提取或人声&伴奏提取拆开音轨,再用音频格式转换导出需要的格式。需要把音乐精确剪进短视频、甚至做成首尾相接的循环背景音时,直接靠听觉粗剪一刀往往会在接缝处出现”咔哒”杂音。正如 Audacity 官方手册关于过零点调整的说明 所指出的,在波形穿过零点位置对齐剪辑边界能减少爆音,这类精细对位工作可在后期剪辑软件里完成;过零点能降低接缝杂音风险,但立体声两声道的过零点可能不同,仍须复听。关于选段和接缝排查的完整做法,可以继续看 短视频 BGM 怎么剪 选段、循环与接缝排查。
新手必须知道的能力边界与创作习惯
把 AI 音乐用顺手之后,很容易产生一种错觉,觉得只要提示词写得够细,模型就能像专业编曲师一样百依百顺。提前认清当前生成模型的几个硬边界,能帮你省下大量无效重试的额度。
第一类边界是精确数值控制。当前生成式音频模型把所有文字提示都视为概率参考,无法可靠执行精确的拍速、小节数、拍号、和弦级数进行、指定秒点乐器进出、或者固定混响时间和响度数值。你可以用”舒缓稳定”或”中速轻快”来引导大致节奏感,但如果需要音乐在第 12 秒准时卡上视频转场,正确的做法是先生成长度足够的候选音频,再到剪辑软件里通过移动音轨、裁剪和淡入淡出完成对齐。
第二类边界是局部修改预期。生成式模型每次出歌都是整体采样,即使只改了歌词里的两个字重新生成,整首歌的旋律和编曲也可能会跟着微调。遇到只差一小段不满意的情况,先做好版本备份。把当前最好的一版下载保存到本地或音频云盘,记下当时用的模型名称、风格描述和歌词文本,再去做下一轮测试,避免改着改着把原本好听的版本弄丢了。
第三类边界是素材使用与合规意识。当你使用自有录音做参考或对音频进行分轨处理时,请务必确认自己对上传的音频拥有合法使用权或已获得明确授权,避免使用未获授权的第三方歌曲或试图复刻特定歌手的个人声线。把创作重心放在你自己的故事、情绪表达和旋律筛选上,作品也更能体现你自己的表达。
上手练习清单
读完上面五步流程,可以先安排十分钟准备与提交一次练习,生成等待和完整试听另计,手感比背诵任何技巧都管用。
- 想一个今天最想记录的画面,用不超过十五个字写下主题,并确定做有歌词的歌曲还是纯音乐。
- 套用”情绪与流派 + 速度感知 + 乐器与演奏方式 + 人声与语言 + 制作空间”公式,拼出一句 40 到 80 个英文单词的风格描述。
- 写四句主歌和四句副歌,在上方分别加上
[Verse 1]和[Chorus],末尾加上[Outro]和[End]。 - 打开 Noema Lab 进入音乐生成,填入歌词、风格描述与标题,按当前模型支持的数量生成候选。
- 完整听完已有候选,挑出更顺耳的一版,用笔记记下哪一句歌词唱得最自然、哪一个提示词帮你稳定了曲风,再用音频裁剪修掉开头多余的空白,你就完成了第一首 AI 音乐候选的生成与筛选。
选择下一步工具
AI音乐生成
输入歌词与风格描述,生成带演唱的歌曲;制作背景配乐时,可选择支持纯音乐的模型。登录后确认本次费用,生成完成后试听、下载,再按需要继续编辑作品。
常见问题
零基础不懂乐理真的能用 AI 做出完整歌曲吗?
可以。目前的文本生成音乐模型已经把旋律编写、和声配置和人声演唱整合在一起,创作者只需要用文字说明想要的风格、情绪和结构,再通过试听挑选合适版本即可。
AI 音乐提示词一定要用英文吗?
英文便于复用常见的流派、乐器和制作术语,但不能据此断言它在所有模型上都比中文稳定。可以先用自己能准确表达的语言描述,再在相同创作目标下比较候选。
歌词框里的方括号结构标签应该怎么写才有效?
把标准英文段落标签单独放在每段歌词上方,例如前奏、主歌、预副歌、副歌、桥段和尾奏的对应英文标记,同时保持段落数量克制,避免堆叠冲突指令。标签只是结构提示,不保证模型执行;括号备注也可能被唱出,生成后仍要核听。
在提示词里写上具体速度数值和指定和弦,AI 一定会照做吗?
不会保证精确执行。生成模型把文字提示当作整体风格倾向来参考,无法像乐谱软件那样严格按指定拍速或和弦级数演奏。需要严格节奏或卡点时,应在生成后通过音频裁剪或混音软件处理。
生成的初版音乐只有副歌好听或时长不够怎么办?
可以先保存满意候选,再按当前模型支持的选项修改输入或重新尝试。分轨和裁剪可为后期重组提供材料,但不会自动延长短音频,也不保证保留原旋律;需要延长时应另行制作。
把读到的方法,带进作品。
账户内可查看当前额度和服务规则,再进入创作工作台。
相关阅读
短视频BGM制作完整指南 从定声音任务到剪辑混音
短视频BGM制作可以分为两条路,需要贴合情绪或避开撞曲时用 AI 生成纯音乐候选,追求快速可控时从素材库选曲。本文拆解动手前的四问声音任务、Noema Lab 站内生成与裁剪流程,以及剪辑软件里的人声避让、重音对齐与淡入淡出实操。
在线 AI 音乐试用怎么准备:账号、模型与输入条件
寻找AI作曲生成器在线免费无需登录的用法时,先分清阅读公开案例和提交自己的任务。Noema Lab音乐生成需要登录,游客可先读教程、整理歌词与风格。本文保留歌曲和纯音乐的最小输入示例,说明账号、模型、额度、试听与下载各要检查什么。
Vlog治愈系配乐怎么做:让旁白、现场声与音乐各有位置
Vlog治愈系配乐先听无音乐版,判断旁白、动作声与环境底声的关系,再用稀疏音乐补足需要的过渡。本文通过冲茶、翻书伴旁白、出门和窗外空镜四段示意,说明如何在 Noema Lab 准备音乐候选、裁出选段,并在剪辑软件中手动安排音乐进出与音量。
游戏解说视频配乐:AI 电子乐候选怎么选
游戏视频里的音乐越燃越好吗?这篇教程从解说、关键游戏原声与配乐的关系出发,介绍四种电子乐候选方向,说明怎样在 Noema Lab 整理提示词、生成候选和裁剪片段,再用同一段解说试听比较,找到有推进感又不遮住信息的配乐。
AI作曲入门2026:零基础先弄清的9个问题
AI作曲入门先分清需要音频、可编辑音符还是乐谱,再练习听旋律、和声与段落。这篇教程用《回家路上》的自拟练习和一次真实文字操作记录,解释怎样在Noema Lab整理描述、试听候选,并用三栏记录决定下一步。
家庭厨房食物损耗记录视频配乐:同一篮前后对照
家庭厨房的食物损耗记录视频要让观众辨认同一篮食材的起始状态、处理动作与可见结果。本文给出前后对照和真实厨房声证据表、虚构一篮蔬菜演练,以及无音乐和带转场音乐两版复听方法。食堂称重、口径可比才能对比的任务见配套短片。