
Noema Lab / 教程
AI唱歌怎么做,先按歌词、旋律和录音选路线
按材料选路线,准备唱词,再用试听记录处理漏字、读音与伴奏问题
本页目录
AI唱歌可以把歌词生成带演唱的新歌,也包括按谱合成或处理已有录音。只有歌词、接受新旋律的人,可以在 Noema Lab 的音乐生成中制作演唱候选;必须保留写定旋律或自己的声音,则要先核对专门的输入能力。先选路线,再准备唱词、逐句试听,并按漏字、读音或伴奏问题决定下一步。
署名 Noema Lab 创作实验室。内容于2026年11月10日修订,文字与教学图由AI辅助制作。
AI唱歌是什么,按手里的材料怎样选路线?
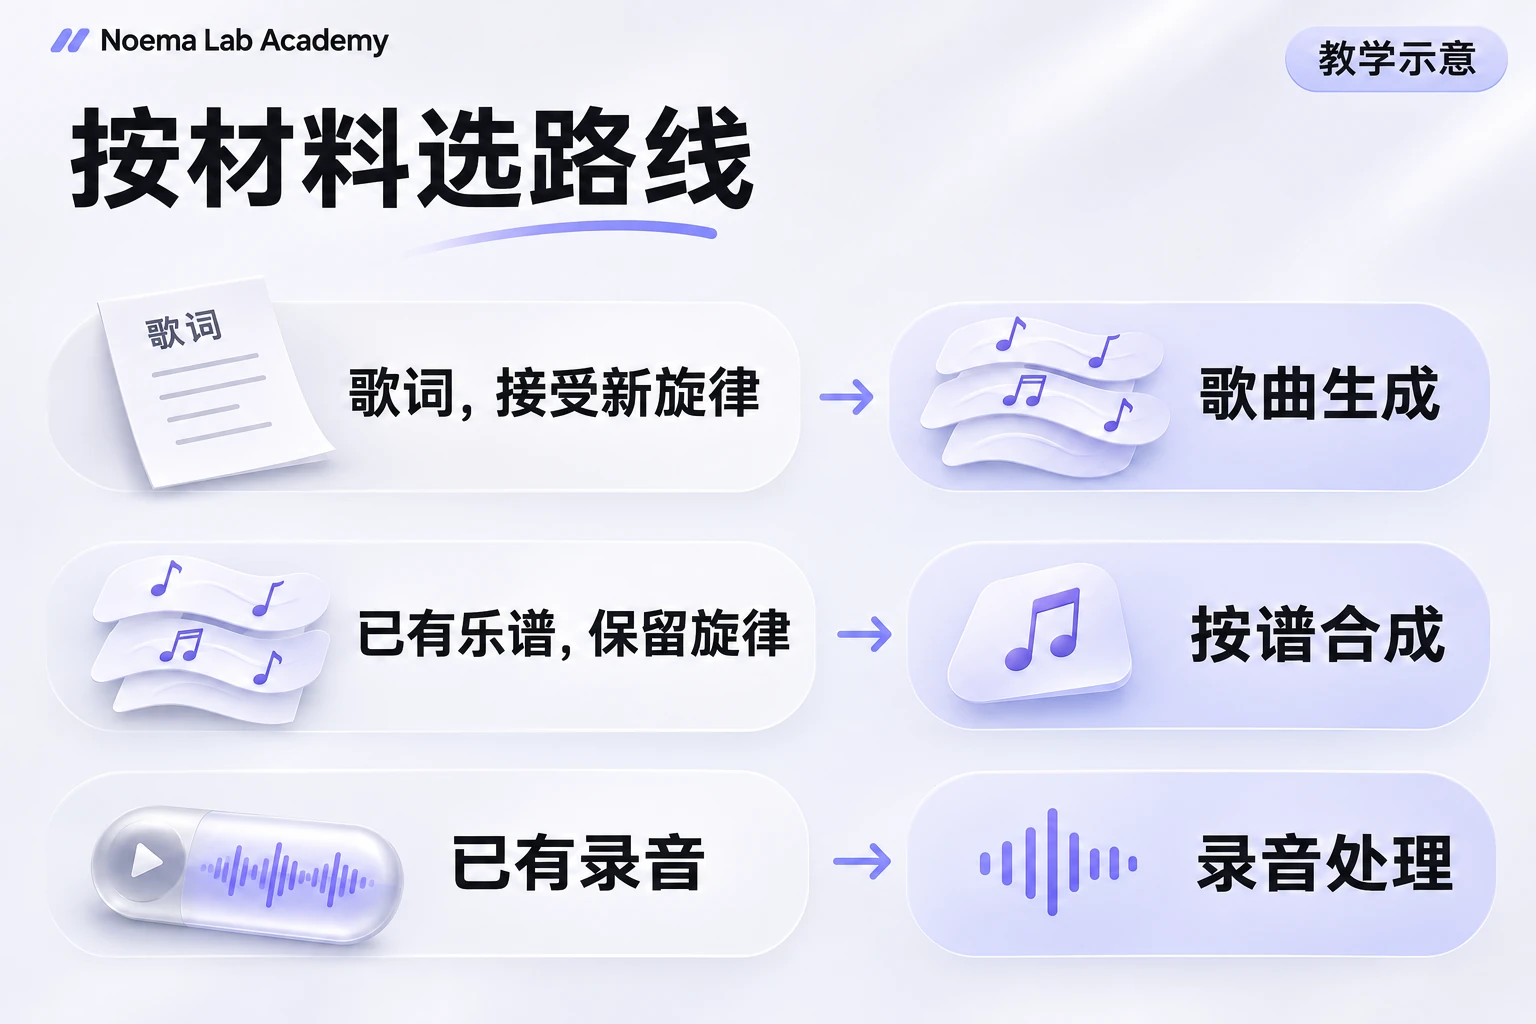
先明确手里的材料和必须保留的内容,路线就能缩小。歌词、乐谱和录音需要的输入不同;照片唱歌还多了一层画面处理。用下表找到自己这次要做的事。
表格可左右滑动
| 你手里的材料 | 这次必须保留的内容 | 优先检查的路线 |
|---|---|---|
| 歌词或创作想法 | 想表达的句意 | 支持人声的歌曲生成 |
| 写定的旋律与歌词 | 已有旋律及歌词关系 | 按谱歌声合成与编辑 |
| 自己唱好的录音 | 原来的演唱细节 | 录音修音、清理或混音 |
| 已有录音,想换声音质感 | 先明确旋律与声音身份要求 | 专门的声音处理或转换 |
| 照片和可用歌曲 | 画面与声音的对应 | 单独制作口型同步视频 |
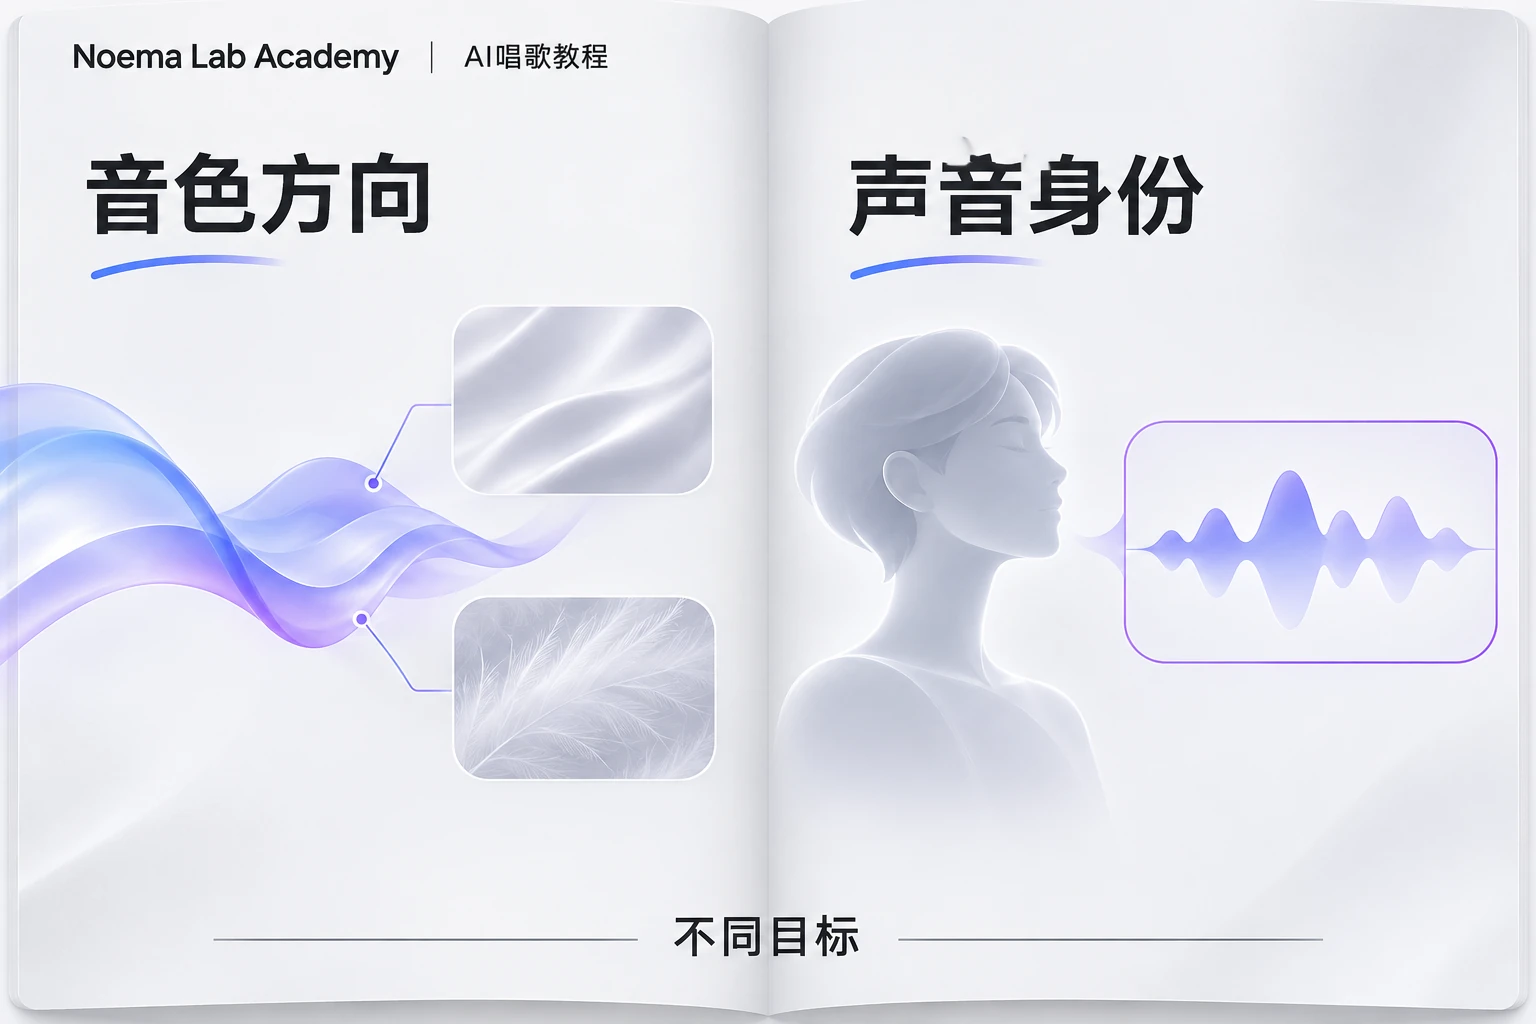
声音质感与声音身份要分开。“温暖的人声”提供音色方向,“每次像同一个人”提出身份要求;男声、女声选项不能证明已经满足后者。
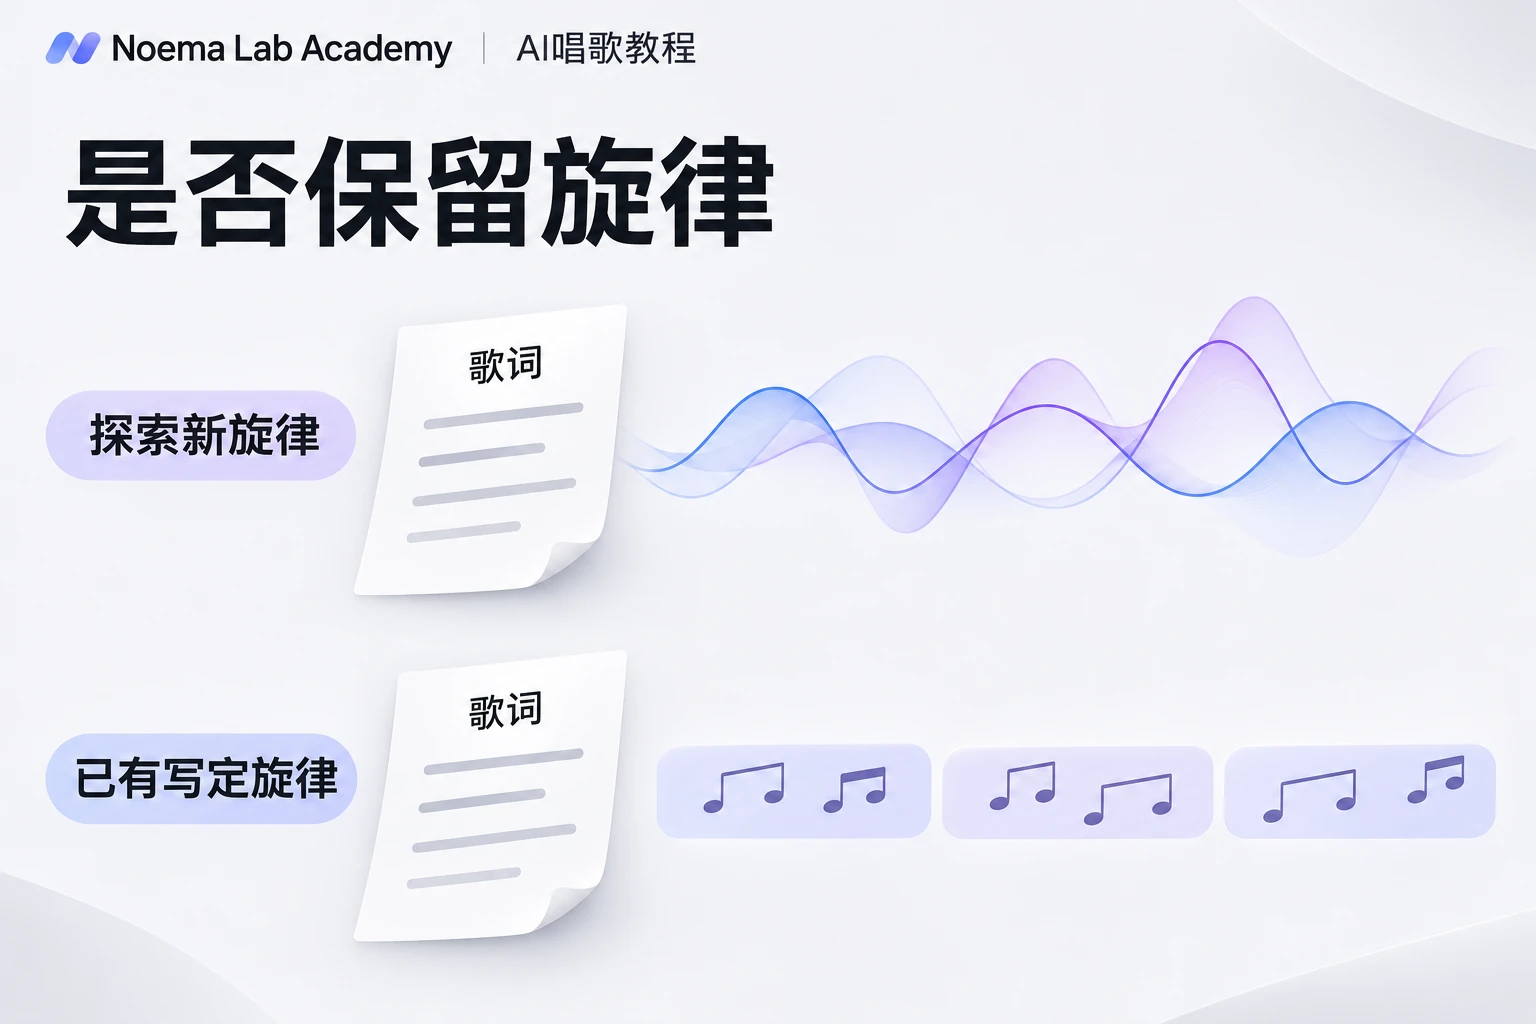
Liu 等人的 DiffSinger 论文(AAAI 2022,arXiv 2105.02446,2022年3月22日 v6)将歌词、音高和时值列为乐谱信息。这个区别很实用,歌词写出了要唱的字,却没有单独写定每个字唱多高、唱多久。已经有旋律的人,选择工具前应检查能否输入和编辑相应音符,以及歌词怎样对应。用一段风格文字描述旋律,无法替代这些材料。
本站音乐 Cover 的部分模型提供 ABC 乐谱输入,属于另一套有格式校验要求的流程;应先确认当前模型确有入口,不能把它等同于普通音乐生成照谱或保证逐字对齐。
已有录音时,先分清要改哪个对象。Qian 等人的 AutoVC 论文(ICML 2019,PMLR第97卷,5210至5219页)讨论声音转换,研究对象是语音,这和根据文字创作新歌有所区别。修音、降噪又各有处理目标。某段录音里只是一个字音不稳,重新生成整首歌可能连带换掉原来喜欢的表情和伴奏,应该先保留原件,再考虑局部编辑。
照片对嘴处理的是画面。Prajwal 等人的口型同步论文(ACM Multimedia 2020,arXiv 2008.10010)研究视频嘴形与目标语音的匹配,说明声音与口型是两个需要分别检查的对象。想让照片唱歌,应先取得自己可使用的音频,再检查画面同步。想练习自己的唱功,则需要自己录唱、听反馈并继续练习,生成一段歌声不会代替这一步。
选工具时要先弄清哪些费用和输出条件?
先确认工具输出混合歌曲还是独立人声,再查格式、费用和中文输入条件。只有适合自己后续用途的文件,才能继续制作;一段片段听起来好听,还不足以替代这些检查。
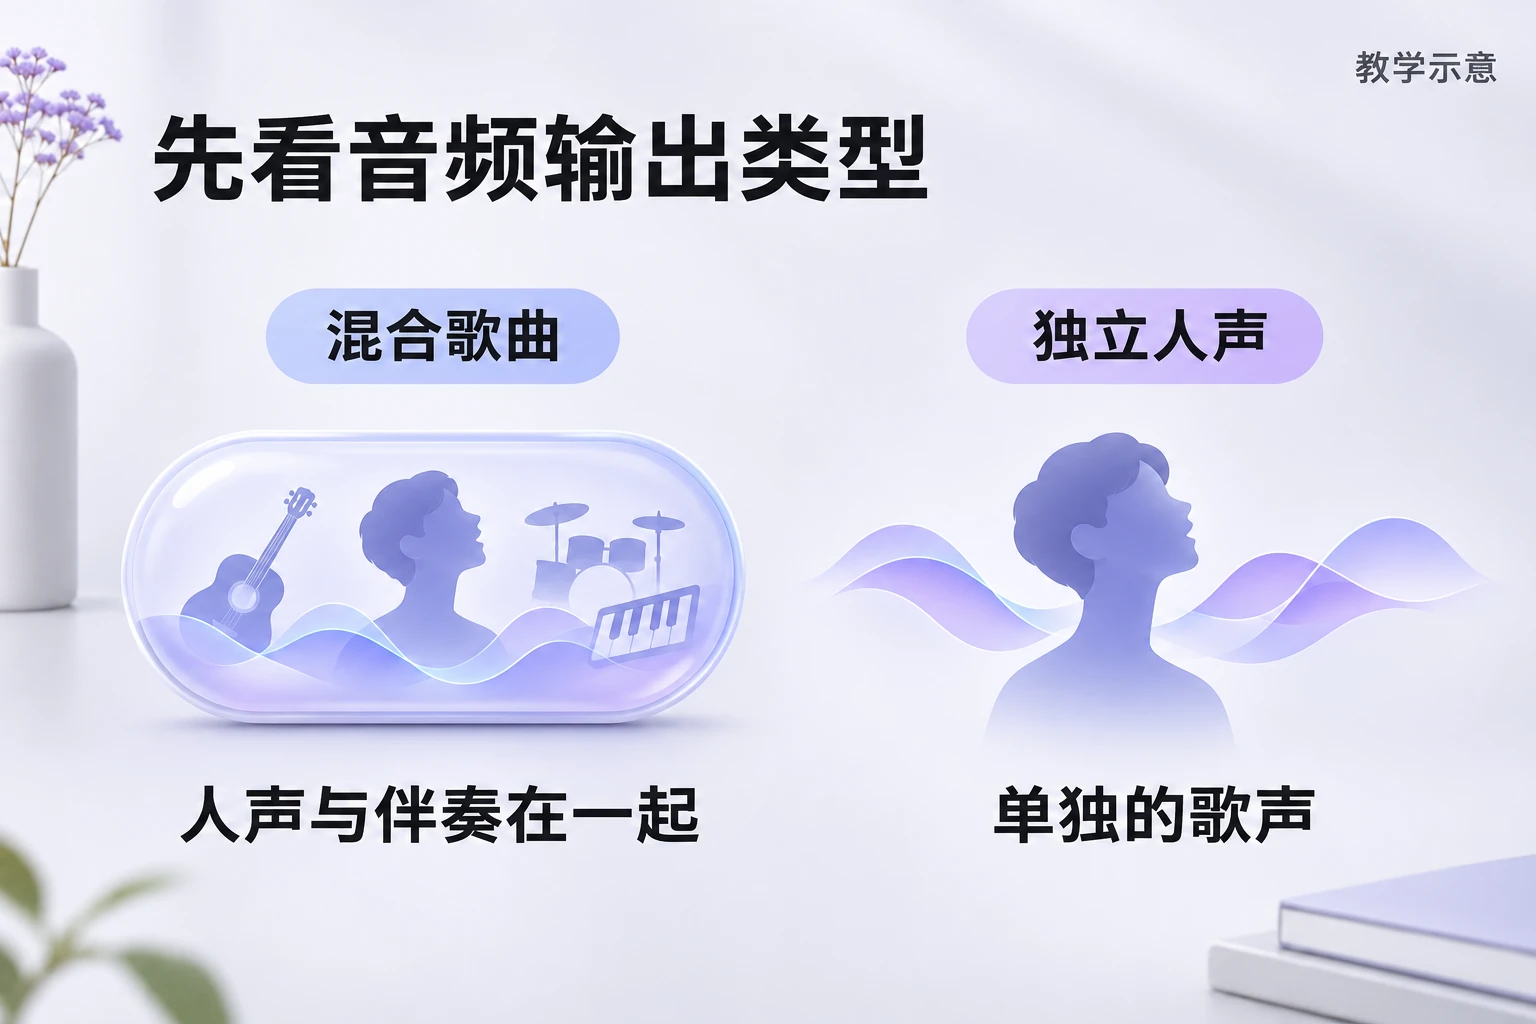
准备自己混音,就要检查独立人声或所需轨道能否导出;只想先听一首完整歌曲,可以从混合音频开始。再把提交次数与候选数量分开看,避免把“生成两首”直接理解为扣两次费用。下面列的是核对对象,具体额度与积分规则以所选工具当前说明为准。
表格可左右滑动
| 核对对象 | 要看清什么 | 与费用的关系 |
|---|---|---|
| 一次提交 | 是否成功受理为一个生成任务 | 不能用连续点击次数代替实际任务数 |
| 生成歌曲数 | 当前模型是否允许选择输出数量 | 输出几首与扣费单位分开核对 |
| 下载和后续制作 | 是否有需要的文件、格式或轨道 | 查看是否另有条件,不从试听可用推断全部免费 |
在 Noema Lab 的音乐生成中,先选模型,再查看“额度说明”与本次预计消耗。额度与积分余额、输出数量是不同的信息,先看清再提交。免费试用也可能有限制;需要上传录音时,还应阅读材料保存、删除和使用说明。
中文支持也要落到自己的句子。一项功能能生成中文演唱,不代表专名、多音字或混合语言都能按期待处理。可以先用自己熟悉的词句开始,遇到问题再查具体输入要求。不要拿其他人的成功片段替自己的材料作保证。
歌词、标题和声音描述该怎么准备?
准备歌词时,把实际要唱的文本单独留一份。人物、动作和否定词先读准,重复的副歌也按本次需要整理。创作要求、读音备注和试听感受另外记,避免一整段说明混进唱词。暂时只有主题的人,先形成可阅读的歌词草稿,再进入歌曲模式。
风格描述用来说明希望听到什么。可以先写主要曲风,再补主人声的表达、伴奏怎样支撑它,以及整体快慢和疏密的感觉。歌词承担故事,声音描述帮助你寻找合适的演绎方向。没有必要把完整故事复制两遍,也不用把“希望感动”反复换成近义词。
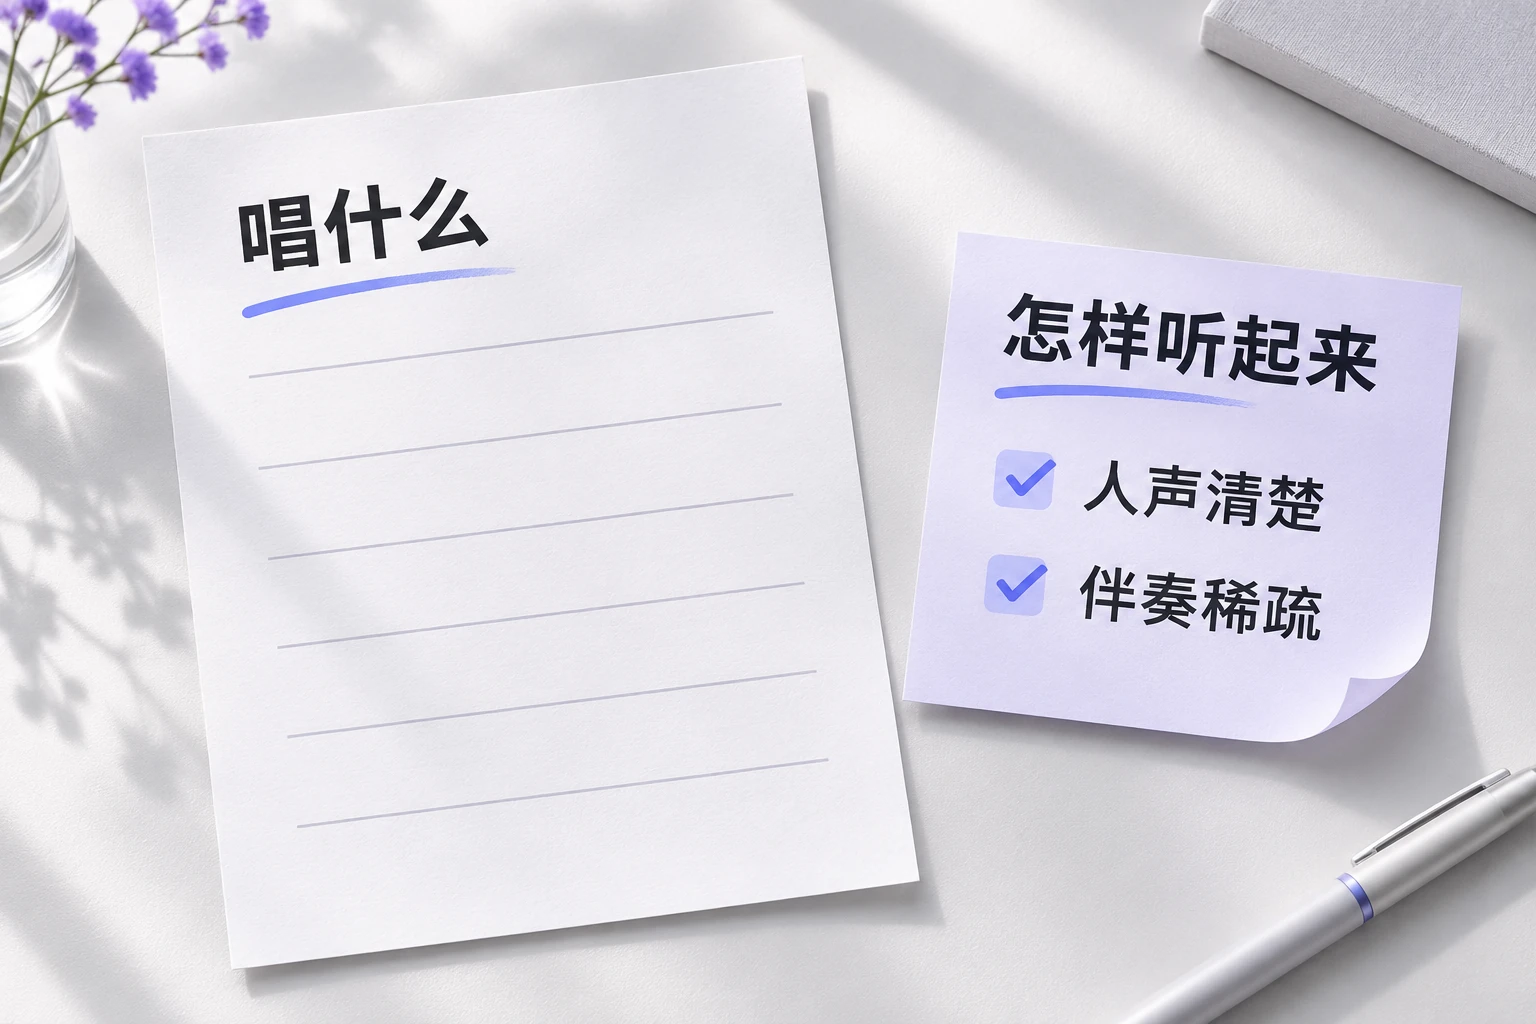
歌曲标题可以先用便于辨认的工作名,例如“雨停以后 初稿”。它帮助区分任务和文件,不承担控制唱法的工作。另存一份本次歌词和风格文字,后面改动时保留旧版。遇到一个字不清楚,还能回到原来的句子判断,而不用凭记忆恢复。
开始前可以照下面几项逐一查看。
- 歌词是准备演唱的文字,复制后换行、重复段和标点没有意外丢失。
- 已经说明是否接受新的旋律,固定旋律或固定声音身份的要求另行核对。
- 风格描述表达一个主要方向,强烈与克制等冲突要求已经选出主次。
- 输入材料由自己创作或已经取得相应使用许可,重要原件留有副本。
- 当前页面的模型、文字限制和费用能够看清,暂时不明白的参数先保留默认。
下面这段是原创教学练习,没有对应的生成音频,也没有预先判定哪种唱法会更好。它只用来展示一份可以继续修改的歌词材料。使用时可以换成自己的内容,不需要沿用这里的人物与场景。
窗边的雨慢慢停了
你把外套搭上椅背
我们说好明早出发
却还没有收好行李
桌上的地图铺开了
车票放在你的杯边
我把没说完的话
留到下一个晴天
如果路上又下起雨
就找个屋檐歇一歇
等远处的车灯亮起
再把今天慢慢说完
这段练习先写出发准备,再转向“没说完的话”。想改成轻快的旅行歌,可以调整人物态度;想保留迟疑,就检查改词有没有把这种意思删掉。确定句意后再考虑声音,避免先套唱法再找内容。
长句、断句和多音字怎样整理?
先检查句意,再改分组或读音表达。长句可以按词组重新排,也可以改写;两者对意思的影响不同,先决定自己允许哪种变化。整理后的文字仍需要试听,不能预先判定一定更清楚。
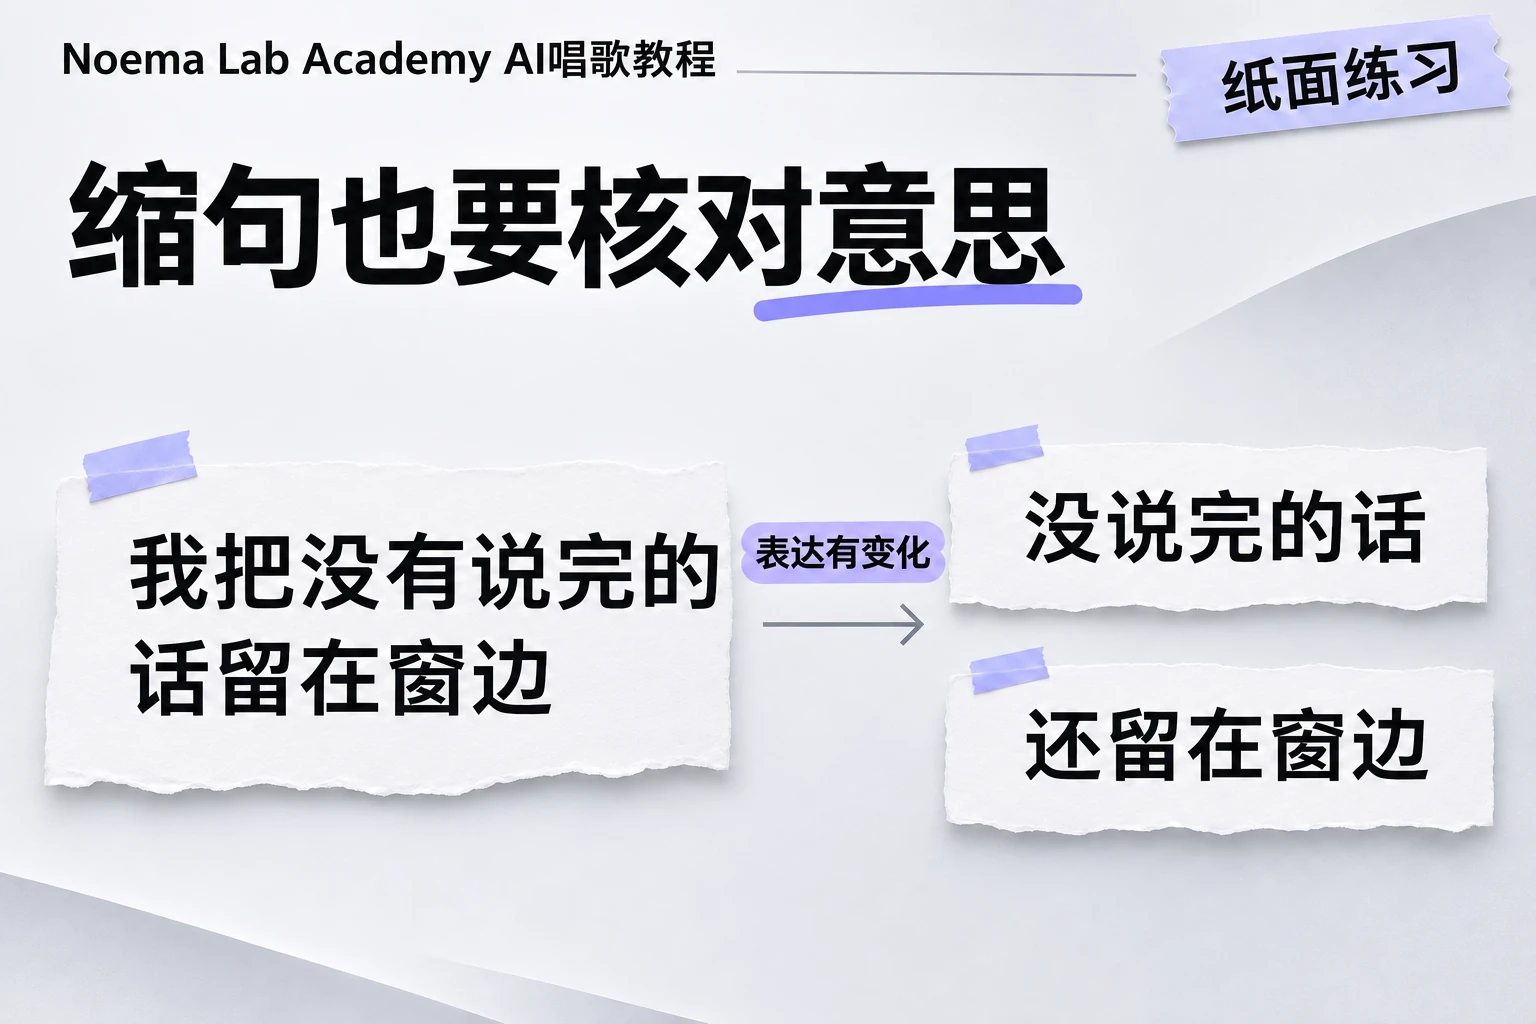
例如“我把没有说完的话留在窗边”,有两种不同选择。接受表达变化时,可以试“没说完的话/还留在窗边”,但主动留下已变成留下后的状态。下图只展示这种缩句,不把它当作等义改写或已经改善演唱的结果。
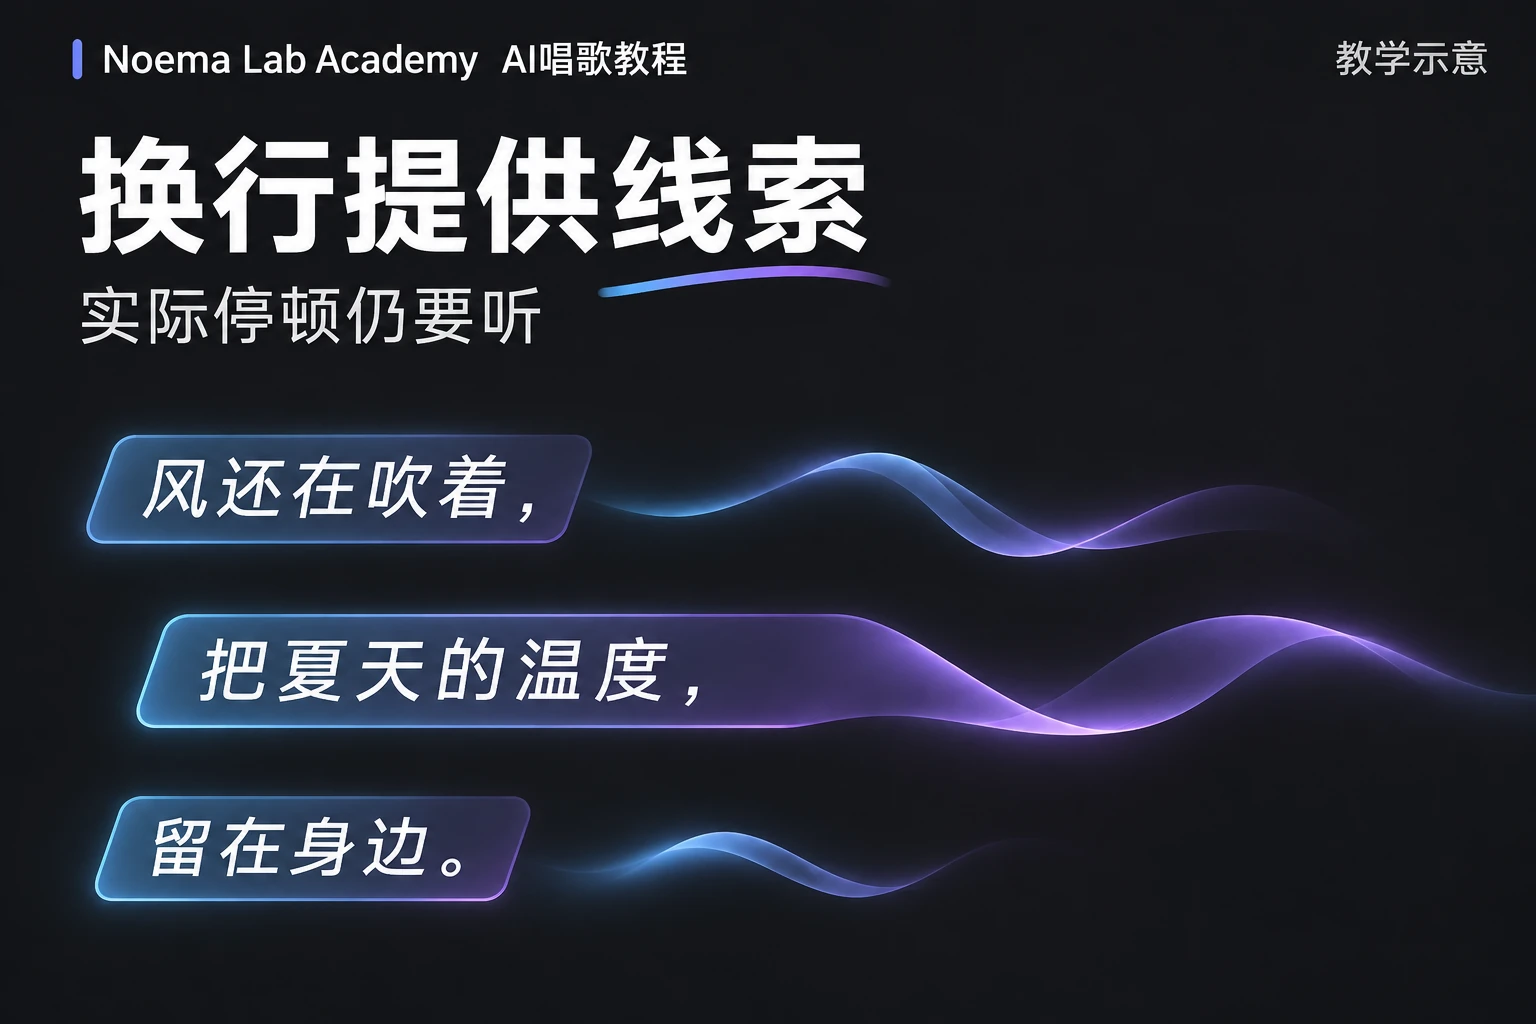
如果想保留“我”的动作,可以先试“我把没说完的话/留在窗边”。这主要调整阅读分组,是否需要在两行之间停顿,仍要结合实际旋律判断。不要把每个换行都当作必然的换气,也不用把所有歌词硬凑成相同字数。
教学练习里的“车票放在你的杯边”包含位置关系。分成“车票放在/你的杯边”仍能读懂,但强调位置的感觉可能变化。保持一行也完全可以。把两种排法读回去,选择与自己表达相符的一版;想继续比较文字组织,可以做歌词分行与人声表达中的同文分行练习。
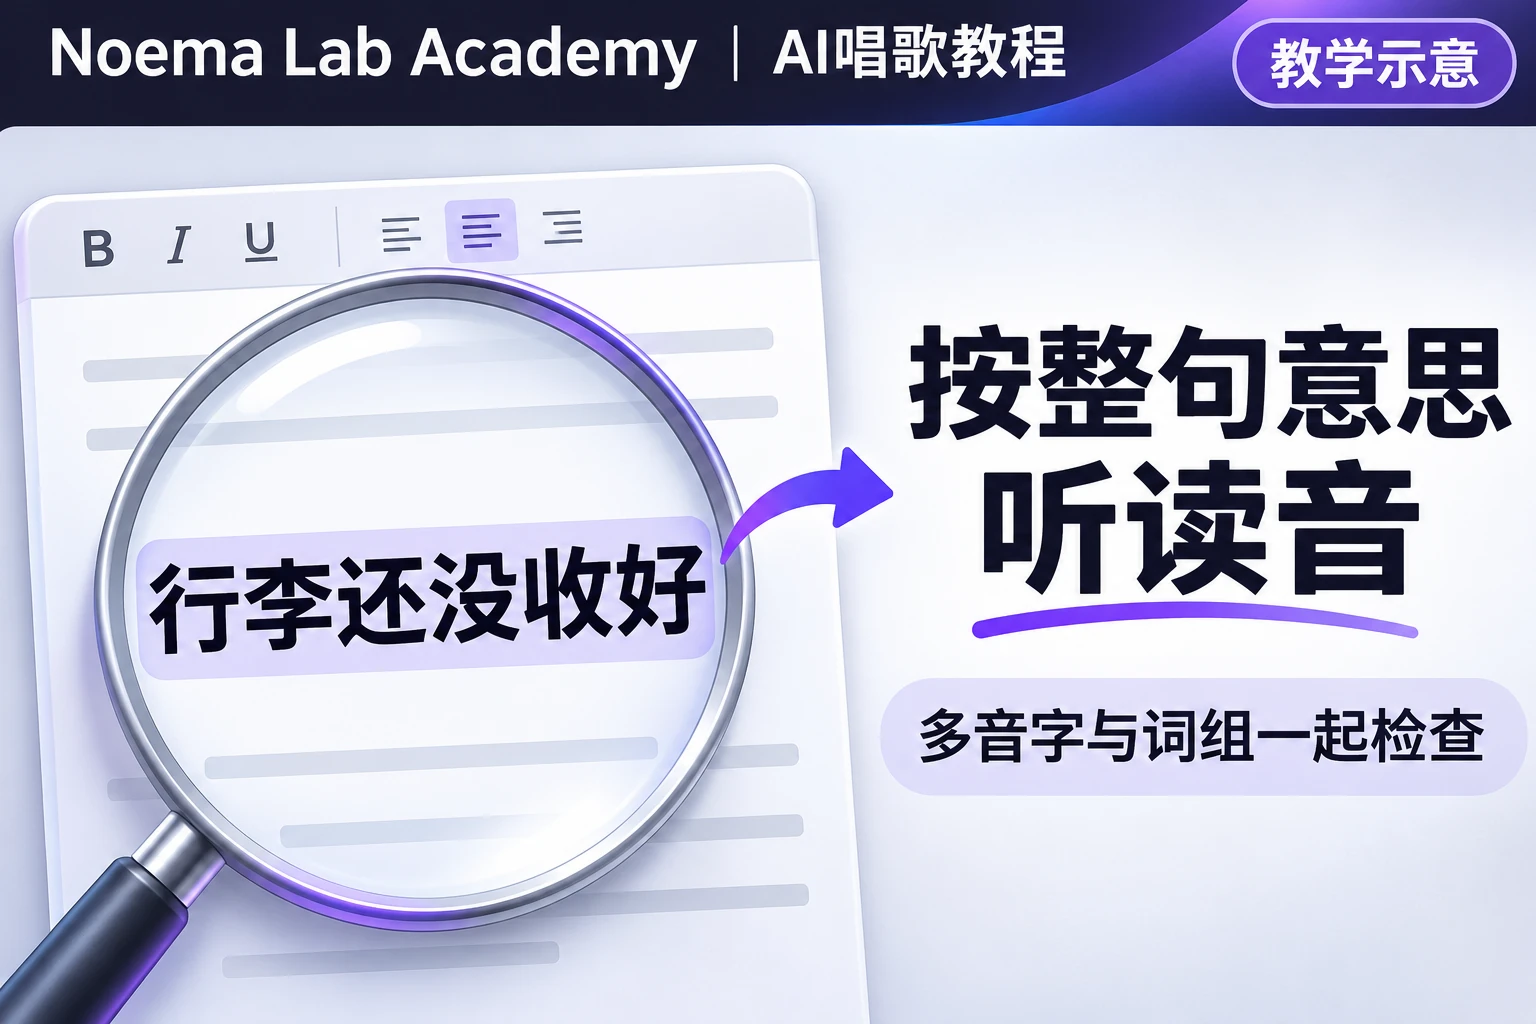
多音字要放回词组检查。例如“行李”和“银行”中的“行”读音不同,先在自己的备注里写清整句读法,专名也单独标记;备注不要混入实际唱词。本站易唱优化输出同音同调替换的文字实验稿,具体用途见同音替代歌词发音实验,实验后仍需对照原词试听。
声音方向能控制到什么程度?
风格描述适合表达曲风、人声状态与伴奏关系,写成可试听的方向即可。音符、拍点和乐器进出需要更具体的乐谱或后期编辑,普通文字音乐生成无法可靠锁定这些细节。
针对上面的练习,可以从这样一段描述开始。抒情流行,以柔和木吉他轻拨和少量钢琴回应支撑主人声。演唱亲近、克制,句子尽量清楚而连贯,整体从容,伴奏不要持续铺满。副歌可以稍微展开,结尾慢慢收束。
这段描述把“清楚”落到了人声与伴奏的关系上,把“安静”落到了乐器与疏密上。它没有指定每个字的时点。试听时可以检查歌词有没有被乐器遮住,副歌展开是否符合表达;未达到愿望的地方,记成下一轮要处理的问题。
需要更明亮的版本,可以把主要方向改为轻快、亲近,其余歌词暂时保留。安静叙述与强烈铺满的声音安排有不同侧重,提交前先选出主次。形容词不必越写越多,能说清这轮主要想听什么就够了。
在 Noema Lab 生成演唱候选的实际步骤是什么?
从 Noema Lab(aimusic-tools.com) 进入,登录后打开“音乐生成”。这条操作适合已经有歌词、接受探索新旋律的人。若想继续了解第一次创作的整体准备,可阅读AI音乐生成器使用教程;下面只围绕听到歌词演唱核对关键动作。
- 在“模型版本”选择当前可用项,先看这个模型提供哪些选项。
- 在“生成模式”选“歌曲”,将唱词放进“歌词”。部分模型只支持歌曲模式;有纯音乐选项时,也不要用它承担唱出歌词的任务。
- 分别填入“风格描述”和“歌曲标题”。粘贴后再看一遍,避免把两栏填反,或只留下一个主题句。
- 检查当前文字限制、模型说明和本次费用,确认材料合适后点击“生成音乐”。
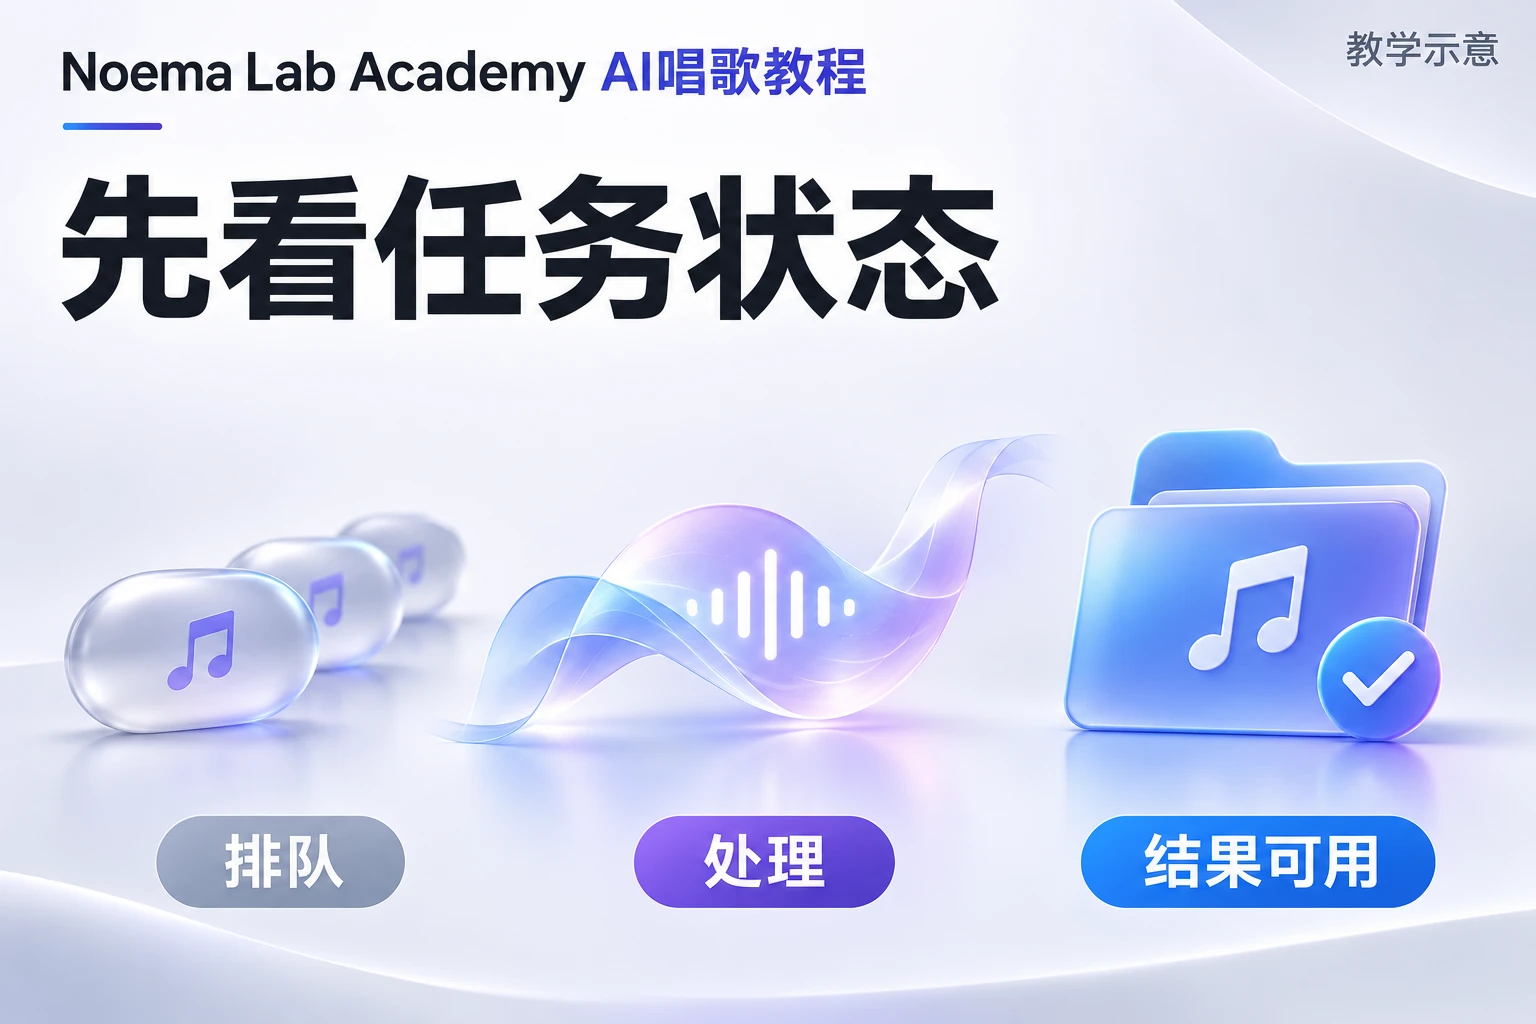
- 在“生成任务”查看状态,手机上可切到“任务列表”。等待任务产生可用结果,再试听和决定是否下载。
部分模型显示“人声性别”,可选自动、男声或女声。它只提供当前模型支持的输入,不代表某个固定人物。高级选项也随模型变化,首次不用为追求清楚而把所有权重都调高,先保留能解释的输入组合。
部分模型还会出现“歌曲时长”的默认、预设或自定义选项。它表达目标时长,实际音频是否符合需要仍要听和查看,不能用它安排某个字在指定一秒出现。没有显示的选项,不要套用别的模型界面;当前输入上限也以页面提示为准。
排队或处理中先查看已有任务,提示不清时也不要连续提交。输入错误按提示修改,任务失败则查看对应状态与消耗记录;没有马上听到声音,不能证明歌词太长或费用已经退回。
听到歌声以后怎样逐句试听和判断?
先不看歌词完整听一遍,记下自己听懂的意思和想回听的句子。暂时不用打分,也不急着决定改哪个字。把这一遍当作检查实际听见了什么,再打开原词,逐句找出文字与声音的差异。
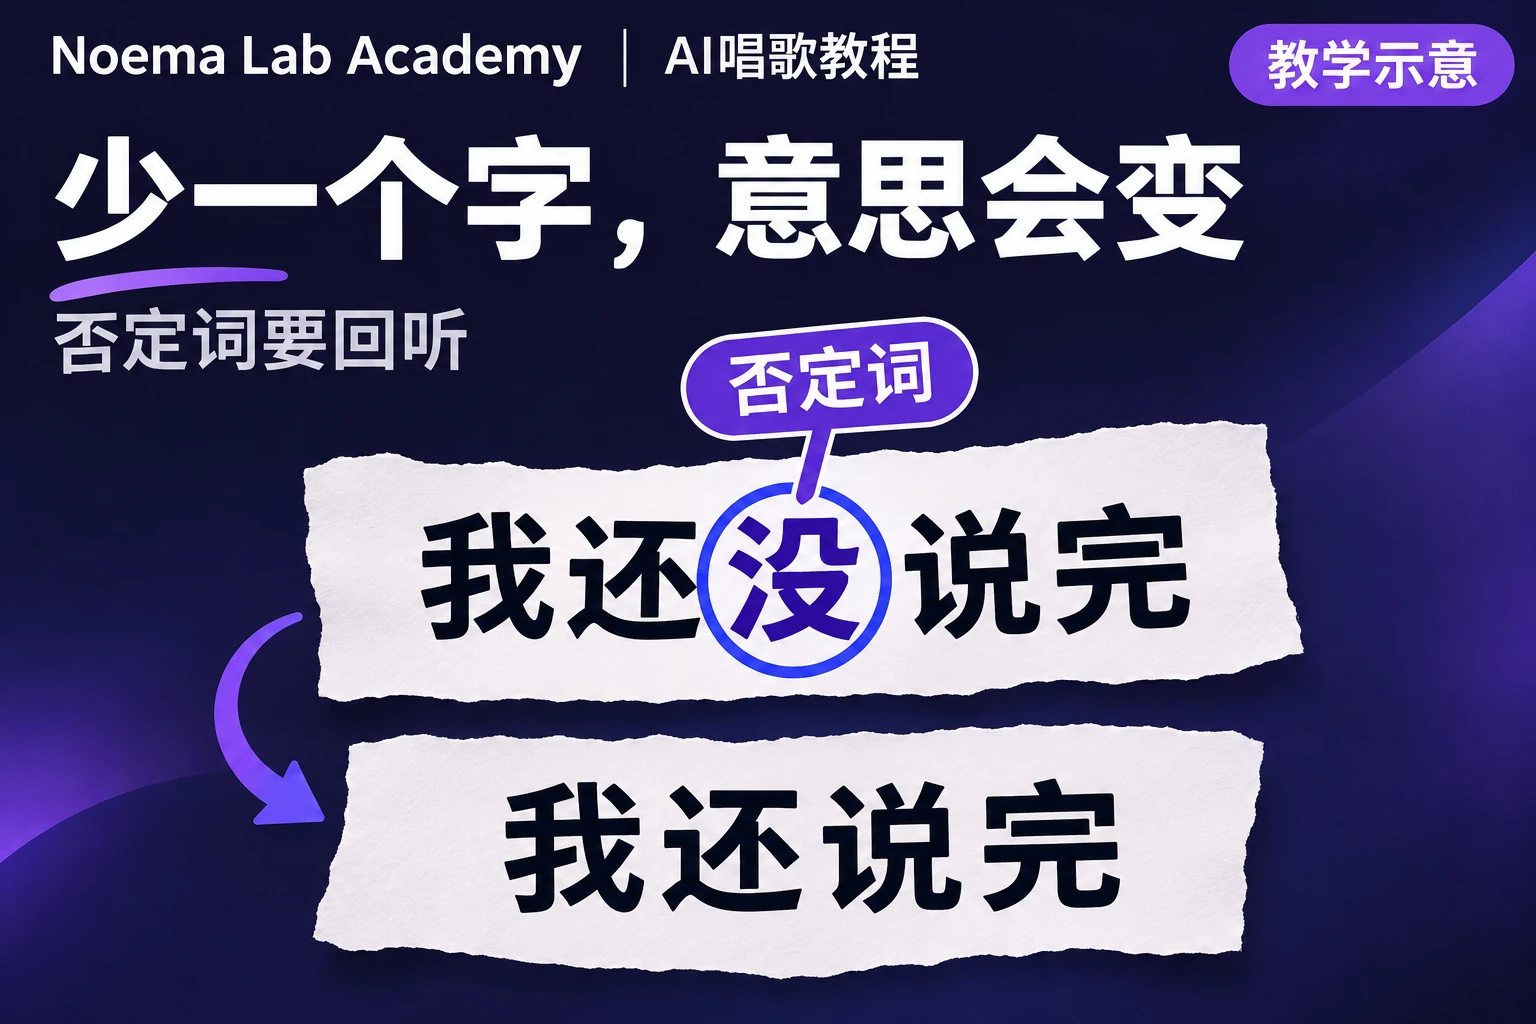
第二遍打开同一版歌词,逐句对照。先查漏字、加词和意外重复,再听词组有没有被拆成另一种意思。“不”“没”“别”尤其值得单独回听,少一个字就可能改变人物态度。遇到多音字,要按整句含义判断,不能只听它像不像某个孤立音节。
句尾长音需要和表达一起看。有的长音保留了情绪,有的把下一句话挤得急促;记录你不接受的是哪一种表现。伴奏遮住人声时,先确认文字是否实际唱出,再判断是音节难辨还是整体音量关系不合适,不必一听不清就立即改词。
可以在自己的文档里留一张空白表,下面每格由真实试听填写。表中的项目是检查方向,没有预填任何生成成绩。
表格可左右滑动
| 检查对象 | 记下听到的内容 | 下一步 |
|---|---|---|
| 漏字、加词、重复 | 自己填写句子和位置 | 对照原词后决定 |
| 多音字和否定词 | 自己填写实际读法 | 判断句意是否改变 |
| 断句、句尾、人声关系 | 自己填写具体表现 | 改文字、声音方向或后期 |
遇到问题时先检查什么,再决定下一步?
发现问题后先按下表核对,决定改文字、声音方向,还是换一条处理路线。先检查已有结果,再考虑是否重新提交。这张表给的是处理顺序,具体问题仍以自己的试听为准。
表格可左右滑动
| 现象 | 先检查 | 下一步 |
|---|---|---|
| 听起来接近念白 | 是否选了歌曲、是否填入实际唱词、描述有无说话要求 | 尝试更有旋律感、连贯的演唱方向再比较 |
| 某句话始终不清楚 | 原词错字、词组、复制内容 | 另存改写并保留原意,或先听其他已有候选 |
| 伴奏拥挤人声被遮 | 文字是否实际唱出 | 把人声与伴奏关系写清楚,或后期处理 |
| 人声清楚但不喜欢 | 具体质感如用力、装饰、距离感 | 选择一个主要方向修改 |
| 写定旋律发生变化 | 是否误用了普通文字生成 | 重新核对按谱输入能力,不继续靠重生成碰运气 |
人声清楚但不喜欢时,把原因写具体,例如过于用力或装饰太多。“温暖”描述声音质感,“克制”侧重演唱表达,选择与问题相符的方向修改,不能把两者当作互相替换的开关。
需要精确调低某条乐器轨道时,先检查能否取得相应轨道并在音频编辑软件中处理。混在一起的整首歌曲与独立轨道不同,不能把“伴奏小一点”的文字愿望当成已经完成混音。已有满意旋律或声音时,先保留文件,再选择后续工具。
一次只改一处,方便自己记清这轮想观察什么,结果仍可能连带改变旋律、音色和伴奏。可以记录“本次这句听清了”,还需要复听和其他候选才能继续判断。新的一版也可能失去原来满意的地方,所以旧文件和输入要一起保留。
怎样下载保存并准备下一次制作?
任务完成且提供可用下载入口后,使用“下载MP3音频”保存。是否有 WAV 看当前模型与结果,试听出现得早,也不表示最终文件已经准备好。遇到下载异常,先查文件与任务提示,不要靠重新生成同一首歌解决保存问题。
在本地打开下载文件,确认是选中的候选,再听开头和结尾是否完整。文件名可以加自己的版本标记,歌词、声音描述与试听备注也留一份副本。下次继续时,先写下自己已有的材料和一项必须保留的内容,再决定沿用这条生成路线,还是转去处理乐谱或已有录音。
资料与示例说明。三篇研究用于区分技术任务,不证明本教程的生成质量。歌词练习与配图都是教学材料,没有对应实测音频;试听建议需用自己的候选验证。
选择下一步工具
AI音乐生成
输入歌曲标题、歌词和风格描述,创作商业级音乐。支持歌曲或纯音乐模式,可选择模型与人声性别,生成后试听、比较并继续编辑。
常见问题
只有歌词,没有旋律,能用AI唱歌吗?
可以选择支持人声的歌曲生成,准备实际唱词、声音方向与标题,取得新的演唱候选。旋律和编配仍需试听判断;如果必须保留写定旋律,应另核对按谱输入能力。
普通音乐生成能一直使用我自己的声音吗?
普通音乐生成不能保证固定声音身份。男声、女声或温暖等音色描述也不能证明结果属于你自己的声音。声音身份需要另核对专门能力,以及录音材料的使用前提。
想保留原旋律,该选择哪条AI唱歌路线?
先检查能输入乐谱并编辑歌词关系的歌声合成路线。本站音乐Cover的部分模型提供ABC乐谱输入,入口和格式依当前模型校验;这与普通文字音乐生成不同,也不保证逐字对齐。
AI唱歌有漏字或中文听不清,应该先改什么?
先对照同一版歌词,定位漏字、读音、词组断句或伴奏遮挡。文字有问题先改文字;需要改变声音关系时再调整描述。新生成也可能改变旋律与编配,要保留原候选继续比较。
AI唱歌是否都免费,出歌数量和扣费次数一样吗?
不同工具和模型的试用、额度与积分规则不同。一次提交、生成歌曲数和下载条件应分开查看;在Noema Lab先选择当前模型,再查看额度说明与预计消耗,不按出歌数量推算费用。
把读到的方法,带进作品。
账户内可查看当前额度和服务规则,再进入创作工作台。
相关阅读
用AI生成歌曲怎么做,歌词准备、生成与下载教程
用AI生成歌曲,先把歌词和声音方向分别准备,再选择歌曲模式生成带演唱候选。本篇提供离家主题的完整教学唱词、句长改写和Noema Lab操作指引,说明怎样核听漏唱、处理伴奏遮挡、选择返工方法,并在下载后确认本地文件。
歌词断句怎么整理:先保留意思,再检查克制唱法
歌词断句怎样配合克制人声?先保留原意,再按当前阅读需要分组,朗读与实际演唱分别检查。本文用同一段原创虚构文字比较三种排法,提供个人分行检查卡、英文短句与人声偏离例,说明Noema Lab文本准备和歌曲输入。短行与空行不锁定停顿或唱法,试听范围和修改理由各自留下。
Noema Lab 易唱优化:同音替代歌词发音实验指南
Noema Lab 易唱优化不是自动改写旋律、断句或押韵,而是把歌词中的汉字尽量替换成同音同调常用字,供音乐生成时做发音对照实验。本文说明输入边界、逐字复核、候选试听、回退方法,以及原稿、实验稿与公开文本必须分开管理的原因。
专属音乐怎么做?创作资料表与三种制作路径
专属音乐可以从一份清楚的创作说明开始。先确定写给谁、表达什么、需要歌词还是音频,再选择自己制作、委托真人或生成候选。教程提供可复制的资料模板、原创虚构的告别歌改写练习和Noema Lab操作步骤,帮助你比较制作范围,准备歌词与声音要求,并核对送出的版本。
提示词版本树怎么复盘:节点对比与回看后检查
提示词版本树复盘先选择已有项目和分支,确认节点内容已保存,再用版本对比查看Prompt与歌词的变化。本文结合Noema Lab当前按钮,说明备注更新、子版本创建、已有音频试听与新生成的区别,并提供虚构节点选择示例和回看后检查清单,帮助你带着可核对的记录继续编辑。
作品发布后怎样提报积分返还:材料、审核与明细核对
公开发布作品后,怎样确认积分返还提报已经收到?这篇教程说明本人 Audio ID、公开分享链接和提报类型怎样对应,区分提交成功与审核结果,再用历史记录及积分明细核对实际返还。两个虚构案例展示未通过后怎样修正材料,以及余额表面没涨时如何查清相关记录。